
昇腾双机落地 DeepSeek-V4.1-Flash-1017:部署文档 + 性能测试来了
本文来源: 老Q(公众号:老Q)
原文链接: https://mp.weixin.qq.com/s/pjKfbhkjg9s8L_zhBDhx3w
发布时间: 2026-10-18 11:05
作者: 老Q 发布时间: 2026-10-18 11:05
昇腾双机落地 DeepSeek-V4.1-Flash-1017:部署文档 + 性能测试来了
10 月 17 日 DeepSeek 开源了 DeepSeek-V4.1-Flash-1017 权重,昇腾侧的 W8A8 量化权重几乎 0day 跟上,vllm-ascend 也在 10 月 15 日放出了 v0.30.0rc2 镜像。老Q第一时间做了落地:2 台 Atlas 800 A2(每台 8 卡 910B3)双机,DP2/TP8/EP16,1M 上下文,目前已在生产运行。
这篇文章交三样东西:一套可以直接抄的部署文档、一轮完整的性能测试数据、一次新老镜像的同机 A/B 对比。对比结论先放这里——rc2 相比老镜像:单请求延迟 -12%、8 并发吞吐 +14%、32k 长上下文 prefill 快约 4.2 倍;代价是 KV cache 每卡少 2.4%。这笔交换老Q认为是赚的,理由在第四节。
结论先行
| 关键问题 | 实测答案 |
|---|---|
| 1017 版是什么来头 | 552B MoE,40 层因果编码器-解码器(CED)架构,原生多模态,上下文 1M(1048576 tokens);Prefill 每 token 激活 8B,Decode 激活 16B |
| 昇腾跑得动吗 | 跑得动。2×Atlas 800 A2 双机(16×910B3 64G),W8A8,DP2/TP8/EP16 |
| 1M 上下文实测 | 扫到 1,042,216 tokens 仍完整返回,实测可用 ≥ 1M(受扫描上限限制,这是下限不是上限) |
| 并发能力 | 16 并发输出吞吐 222.10 tok/s;1/2/4/8/16 全档位错误率 0.00% |
| rc2 比老镜像强多少 | 延迟 -12%、8 并发吞吐 +14%、32k 长上下文 ≈4.2×;KV cache 每卡 -2.4% |
| 必须打的补丁(背靠背组网必须) | patch_allgather.py。vllm-ascend #7606:背靠背组网 MC2 不支持,强制 MoE 通信走 ALLGATHER |
一、万众期待的 1017,和几乎 0day 的昇腾适配
1.1 官方 10 月 17 日开源,跑分确实亮眼
10 月 17 日下午,DeepSeek 官方公众号发文《DeepSeek V4.1 Flash 新版本:许愿式编程一键成真》,正式开放 DeepSeek-V4.1-Flash-1017 权重,HuggingFace 和 ModelScope 同步上架(链接在文末)。官方网页端、APP 和 API 也同步切到了新模型。
官方通稿里最实在的一条是"性能-费用的帕累托改进":相比上一版 V4.1 Flash,新模型各方面基准测试都有提升,同时任务运行时间和输出长度都缩短了,在多个 Harness 下达到了新的性能-费用帕累托最优。官方还点名针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架做了优化,建议 Harness 升到 0.2.1-rc.1 以上。
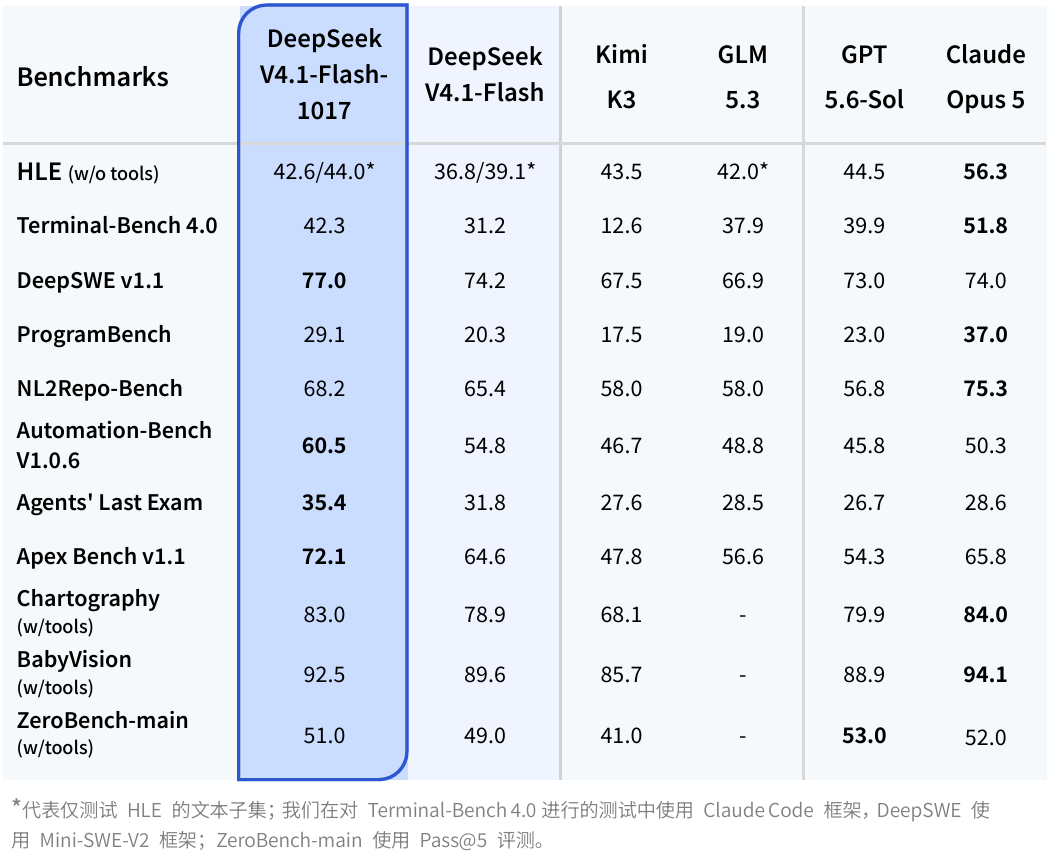
官方原图脚注的口径:† 代表测试 HLE 的文本子集;Terminal-Bench 4.0、Exploit Gym、SecBench Pro 使用 Claude Code 框架测试,DeepSWE 使用 Mini-SWE-V2 框架。跨框架的分数不要直接横向比。
这一版还把自研搜索 API 对公众开放了(Search / Fetch,5 元/千次,2026 年 11 月 1 日起计费),以及基于自反馈 RL 的"许愿式编程"能力——官方演示了让它从零写网页赛车游戏、复刻《传送门2》、搭 3D 场景。这些是模型侧的事,老Q只关心能不能在昇腾上扛住生产,往下看。
1.2 模型架构:天生是给长上下文 Agent 场景设计的
按 vllm-ascend 官方模型文档和 vLLM 官方博客的口径,V4.1-Flash 的几个关键设计:
| 设计 | 作用 |
|---|---|
| 552B MoE 主干,40 层 CED(20 编码器 + 20 解码器) | Prefill 每 token 只激活 8B,Decode 激活 16B——预填充便宜,解码才贵 |
| CSA2 + FP4 主 KV 缓存 + 跨层共享 | 全局 KV 压到每 token 约 890 字节;持久化 KV 占用降到 V4-Flash 的约 1/8 |
| SWA 有界重放 | 前缀缓存命中时只重算最近 128 个 token,长上下文 prefill 大幅瘦身 |
| Engram 条件记忆 + DSpark 投机解码 | 查表加速 + 投机解码提吞吐 |
| 原生多模态 + 1~100 连续可调推理强度 | 文本图像混合输入;推理强度可调 |
对部署侧的直接意义:KV 小,所以双机 16 卡就敢开 1M 上下文;prefill 便宜,所以长文档场景的首字延迟有救。这两点后面都用实测数据验证了。
1.3 昇腾侧:W8A8 权重 0day,镜像到位
权重开源后,适配昇腾的 W8A8 量化权重(728 GB、138 个分片)几乎 0day 跟上;vllm-ascend 这边,10 月 12 日发 rc1、10 月 15 日发 rc2,DeepSeek V4.1 的优化基本都在这两个版本里。老Q也是第一时间拉权重、起服务、跑压测,本文就是这套流程的完整记录。
先放本次落地的基本盘:
| 项 | 值 |
|---|---|
| 权重 | DeepSeek-V4.1-Flash-1017-w8a8(W8A8,728 GB,138 分片) |
| 镜像 | quay.io/ascend/vllm-ascend:v0.30.0rc2 |
| 硬件 | 2× Atlas 800 A2(每台 8×910B3 64G),NPU 200G RoCE 背靠背直连 |
| 拓扑 | 全局 DP2 / TP8 / EP16,node0 为 head 暴露 API,node1 headless |
| 上下文 | 1M(1048576),block 128 |
二、v0.30.0rc2:好马配好鞍
2.1 先说清楚 rc1 和 rc2 的分工
这两个包经常被混为一谈,老Q先把官方 release notes 的分工摆出来:
| 版本 | 发布日期 | 内容 |
|---|---|---|
| v0.30.0rc1 | 10 月 12 日 | 主体版本。对齐上游 vLLM v0.30.0,聚焦四大旗舰模型:DeepSeek V4.1、GLM-5.3、GLM-5.3-Flash、Qwen3.8-27B,DeepSeek V4.1 的优化全在这里 |
| v0.30.0rc2 | 10 月 15 日 | 补丁版本。无代码变更,只修 Dockerfile——CANN 升级到 9.2.0_20260930220649,保证官方镜像正常构建;官方明确建议在用 rc1 官方镜像的升级到 rc2 |
生产直接上 rc2 就行,别纠结。
2.2 DeepSeek V4.1 优化点清单(官方 release notes 口径)
老Q把 rc1 Highlights 里 DeepSeek V4.1 相关的条目逐条摘出来,附上人话解释和"对本场景是否相关":
| # | 官方原文 | 人话解释 | 本场景 |
|---|---|---|---|
| 1 | Added DeepSeek V4.1 support on Model Runner V2 | V2 执行器支持 V4.1 | ✅ 已启用(VLLM_USE_V2_MODEL_RUNNER=1) |
| 2 | Enabled torch.compile | 开启编译加速,融合 norm/act 量化等算子 | ✅ 生效 |
| 3 | Sped up startup via in-place rotary embedding | 就地旋转位置编码,少一次大张量拷贝,启动更快 | ✅ 生效 |
| 4 | Reused filtered RoPE lookups | 复用过滤后的 RoPE 查找表,省重复计算 | ✅ 生效 |
| 5 | Removed redundant DSV4.1 indexer/SP copies | 删掉 indexer/SP 的冗余拷贝 | ✅ 生效 |
| 6 | TurboQuant 4-bit latent KV cache(DSA 稀疏模型,仅 DeepSeek V4 Flash,A2/A3) | 4-bit latent KV 缓存 | ⚠️ V4 Flash 专属,V4.1 用不上,别强开 |
| 7 | Packed KV cache in the V1 runner | V1 也支持打包 KV | 本轮用 V2,无关 |
| 8 | Fixed ModelSlim-quantized DSV4 weight layout | 修复 ModelSlim 量化的 DSV4 权重布局问题 | ✅ 相关,W8A8 权重正是 ModelSlim 生态 |
| 9 | Added AscendStore preparation for V4.1 | 为 V4.1 准备 AscendStore 对接 | PD 分离拓扑才用得上 |
| 10 | Packaged attention operators (QLI/QSLI/MQSMLA) with DSL | 用 DSL 打包注意力算子 | ✅ 相关,长上下文收益的主要来源之一 |
另外 Features 里还有 DeepSeek V4.1 PCP 支持、GQA PCP/DCP 叠加等——都是 PD 分离拓扑的能力,本轮双机共置用不到,列出来供后面要扩 PD 的同学参考。
2.3 官方支持矩阵:A2 在列,这是敢上 910B3 的依据
rc1 发布说明里的硬件支持范围写得很清楚:
| 模型 | 支持硬件 | 发布范围 |
|---|---|---|
| DeepSeek V4.1 | Atlas 800I A3 / Atlas 800I A2 | W8A8 serving;Model Runner V2 执行、torch.compile、P/D 部署 |
A2 在官方支持矩阵里,而且官方模型文档明确写了"vLLM Ascend 支持在 Atlas 800 A3 和 A2 服务器上进行 W8A8 部署"——这就是老Q敢直接把 1017 版放上 910B3 双机的依据,不是野路子。
依赖版本(rc1 release notes 口径):vLLM v0.30.0、CANN 9.2.0、Ascend HDK 26.1.1、PyTorch/torch_npu 2.10.0、Triton Ascend 3.2.2、Python 3.12。
⚠️ 一个容易踩的点:rc1 的 Known Issues 里明确写了"MRV2 默认全开被回退,仍是 opt-in"。所以启动脚本里必须显式VLLM_USE_V2_MODEL_RUNNER=1,不开就退回 V1,第四节的对比数据会有偏差。
2.4 好马配好鞍
DeepSeek-V4.1-Flash-1017 + vllm-ascend:v0.30.0rc2,模型侧把 KV 压到每 token 890 字节、prefill 砍半,引擎侧把 V2 执行器、torch.compile、DSL 算子打包全安排上——老Q对这个组合的期待值拉满。下面一起搞起。
三、部署结论与性能测试
3.1 部署结论
先给结论:这套组合在 2×A2 双机上跑得通、跑得稳,已在生产运行。
| 项 | 结果 |
|---|---|
| 服务状态 | 生产运行中(即第四节 A/B 对比的胜出版本) |
| 冒烟验证 | 中文推理完整输出(finish=stop);英文数学 2^10+24=1048 正确;工具调用 finish_reason=tool_calls + get_weather(city=北京) |
| 稳定性 | 双节点 0 Traceback / 0 561000 |
| 显存水位 | HBM 92% / 91%(0.90 配置下的正常水位) |
| 服务指纹 | vllm-0.30.0-tp8-dp2-ep-849b8c9f |
| V2 runner | 日志确认 npu model runner v2 生效 |
3.2 测试口径(先立规矩)
- 测试标准版本
v1.1;生成最大 token 数 1024;温度 0.0 - 并发扫描 1/2/4/8/16,每级 16 请求、预热 2
- 上下文容量扫描 1,024 → 1,048,576,真实长文填充 + 二分逼近
- 压测客户端:96 核 CPU / 503 GB 内存,与服务端同内网(主机信息已脱敏)
- 本报告只评估性能(吞吐/延迟/并发/错误率)与上下文容量,不评估模型智能程度
3.3 上下文容量:1M 是真的能跑满
| 项目 | 值 |
|---|---|
| 模型声明上下文 | 1,048,576 tokens |
| 实测可用上下文 | ≥ 1,048,576 tokens(受扫描上限限制) |
| 达到声明值比例 | ≥ 100.0% |
探测过程(共 11 次,全部成功、响应质量正常):
| 探测长度 (tokens) | 首字延迟 (ms) | 总耗时 (ms) |
|---|---|---|
| 1,017 | 470.9 | 2,157.5 |
| 2,041 | 3,067.2 | 5,067.6 |
| 4,074 | 3,005.4 | 4,765.0 |
| 8,142 | 2,990.9 | 4,841.1 |
| 16,289 | 1,686.6 | 3,264.3 |
| 32,569 | 2,322.5 | 3,590.8 |
| 65,139 | 7,887.5 | 9,489.8 |
| 130,277 | 14,053.8 | 15,106.8 |
| 260,559 | 20,822.0 | 21,835.3 |
| 521,113 | 77,020.8 | 78,167.3 |
| 1,042,216 | 166,569.8 | 168,249.3 |
3.4 常规性能
延迟(全量混合,98 请求):
| 指标 | Min | P50 | P90 | P95 | P99 | Max |
|---|---|---|---|---|---|---|
| TTFT(ms) | 384.06 | 469.35 | 5,702.25 | 5,966.85 | 7,215.52 | 7,221.88 |
| TPOT(ms) | 9.15 | 20.41 | 37.29 | 41.65 | 79.79 | 80.41 |
| 端到端(ms) | 1,326.81 | 8,644.37 | 26,177.15 | 30,603.38 | 32,704.55 | 32,898.13 |
| 输出速度(tok/s) | 12.44 | 49.01 | 83.10 | 95.54 | 107.70 | 109.27 |
按负载阶段拆开看(分位数仅在同一阶段内解释):
| 阶段 | 请求数 | TTFT P50 / P90 / P99 (ms) | TPOT P50 (ms) | 端到端 P50 / P90 (ms) |
|---|---|---|---|---|
| 顺序段 | 8 | 467.1 / 1,621.8 / 2,845.8 | 16.62 | 7,996.9 / 26,124.5 |
| 并发段 | 80 | 470.3 / 5,948.7 / 7,216.7 | 21.35 | 9,751.5 / 26,848.5 |
| 多模态段 | 5 | 527.8 / 564.9 / 584.4 | 12.03 | 5,340.3 / 10,710.4 |
| 多模态文本基线 | 5 | 464.6 / 474.7 / 475.2 | 13.01 | 4,780.7 / 14,514.3 |
吞吐与稳定性:
| 指标 | 值 |
|---|---|
| 请求数(成功 / 失败) | 98 / 0 |
| 成功率 | 100.00% |
| 输出 token 数 | 47,862 |
| 总耗时(累计请求耗时) | 1,203.01 s |
| 测试窗口时长 | 580.70 s |
| 输出吞吐 | 39.79 token/s |
| 请求吞吐 | 0.169 req/s |
| 平均每请求输出 token 数 | 488.4 |
口径提醒(重要,避免两组数看着"打架"):39.79 token/s 是全窗口累计(47,862 tokens ÷ 1,203.01 s 累计请求耗时,含全部阶段与预热);下一节并发表的 222.10 token/s 是16 并发档测量窗口内的吞吐。两个数口径不同,都列出来,别混着吹,也别混着黑。
3.5 并发扩展性
| 并发数 | 吞吐 (tok/s) | 请求吞吐 (req/s) | P50 延迟 (ms) | 错误率 |
|---|---|---|---|---|
| 1 | 50.46 | 0.097 | 6,259.83 | 0.00% |
| 2 | 75.11 | 0.155 | 11,129.76 | 0.00% |
| 4 | 130.54 | 0.283 | 6,123.27 | 0.00% |
| 8 | 206.95 | 0.391 | 11,204.01 | 0.00% |
| 16 | 222.10 | 0.485 | 12,868.83 | 0.00% |
典型的"吞吐换延迟"曲线:并发从 1 加到 16,吞吐从 50.46 爬到 222.10(4.4 倍),P50 延迟从 6.3s 爬到 12.9s。16 并发触顶,再往上加并发估计也是在这个量级附近震荡——对内服务场景,这个量级基本够用,真要更高吞吐就得考虑加机器或者上 PD 分离了。
3.6 多模态
| 指标 | 值 |
|---|---|
| 测试请求数 / 图片数 | 5 / 1 |
| 图片输入 TTFT P50 | 527.81 ms |
| 图片输入端到端 P50 | 5,340.34 ms |
| 图片处理开销(TTFT) | +50.93 ms(对比纯文本基线 464.6 ms) |
样本量小(5 请求 1 张图),只看趋势:图片输入比纯文本基线首字慢约 63 ms,多模态链路是通的,没有明显劣化。要下结论得补样本。
3.7 稳定性
98 请求全部成功,错误率0.00%,总测试时长 580.70 s。全档位并发 + 长上下文探测 + 多模态,没有一次失败。
四、新老镜像 A/B 对比实测
4.1 测的是什么
回答一个问题:rc2 相对老镜像quay.io/ascend/vllm-ascend:deepseek-v4.1-flash(vLLM 0.27.1 构建)的官方优化点,在这套 2×A2 双机上吃到了多少?
4.2 结果总表(改善项矩阵)
| 指标 | 老镜像(0.27.1 + V1) | rc2(V2 + 1017 权重) | 变化 |
|---|---|---|---|
| KV cache 可用容量/卡 | 13.96 GiB | 13.63 GiB | -0.33 GiB(-2.4%) |
| NPU KV cache tokens | 3,257,298 | 3,180,174 | -77k(-2.4%) |
| 1M 上下文最大并发 | 3.11x | 3.03x | -0.08x |
| 启动至 ready | ~14 min | ~14 min | 持平 |
| 单请求延迟(256 tok,×5 均值) | 3.54 s | 3.11 s | -12% |
| TTFT(均值) | 0.43–11.5 s(冷启抖动大) | 0.50–0.57 s(稳定) | 抖动消除 |
| 8 并发 wall time | 8.13 s | 7.11 s | -12.5% |
| 8 并发吞吐 | 251.9 tok/s | ~288 tok/s | +14% |
| 长上下文(32k prompt + 128 out) | 12.115 s | 2.884 s | -76%(≈4.2×) |
| 工具调用 | 支持 | 支持(finish=tool_calls,get_weather(city=北京)) | 持平 |
| HBM 水位(0.90 配置) | ~91% | 92% / 91% | 持平 |
| 错误签名(Traceback / 561000 / HCCL) | 0 | 0 | 持平 |
五、部署环境与可复制文档
5.1 环境交代
| 项 | 值 |
|---|---|
| 镜像 | quay.io/ascend/vllm-ascend:v0.30.0rc2(vLLM 0.30.0 + vllm-ascend 0.30.0rc2) |
| Model Runner | V2(VLLM_USE_V2_MODEL_RUNNER=1) |
| 权重 | DeepSeek-V4.1-Flash-1017-w8a8(728 GB,138 分片,两节点路径一致) |
| 模型名 | deepseek-v4.1-flash-1017 |
| 硬件 | 2× Atlas 800 A2(每台 8×910B3 64G),NPU 200G RoCE 背靠背直连 |
| 拓扑 | 全局 DP2 / TP8 / EP16;node0 = head(API :7000),node1 = headless |
| 上下文 | 1M(max_model_len 1048576),block 128 |
| 补丁 | patch_allgather.py 必打(#7606 背靠背组网 MC2 不支持) |
| 环境变量 | VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS=3000(1M prefill 超时保护) |
| 容器名 | deepseek-v41-node0 / deepseek-v41-node1 |
脱敏说明:下文脚本中的 、、、/path/to/models、/path/to/dsv41_logs 均为占位符,部署时替换为实际值;/dev/davinci*、/usr/local/Ascend/...、/usr/local/dcmi、/etc/ascend_install.info 等为硬件/框架标准路径,原样保留。
5.2 部署七步(全部可复制)
① 前置确认(两节点 SSH 互通 + 老链路 UP + 权重/镜像在位):
# RoCE 口不响应系统 ping,用 hccn_tool 探活
ssh root@node0_ip 'hccn_tool -i 0 -netdetect -s address node1_roce_ip && hccn_tool -i 0 -ping -g address node1_roce_ip'
ssh root@node1_ip 'hccn_tool -i 0 -netdetect -s address node0_roce_ip && hccn_tool -i 0 -ping -g address node0_roce_ip'

# 权重就位(两节点路径必须完全一致)
ssh root@node0_ip 'test -f /path/to/models/DeepSeek-V4.1-Flash-1017-w8a8/config.json && ls /path/to/models/DeepSeek-V4.1-Flash-1017-w8a8/*.safetensors | wc -l'
ssh root@node1_ip 'test -f /path/to/models/DeepSeek-V4.1-Flash-1017-w8a8/config.json && ls /path/to/models/DeepSeek-V4.1-Flash-1017-w8a8/*.safetensors | wc -l'

# 镜像在位(两节点同一 tag,tag 不一致会出现算子行为差异)
ssh root@node0_ip 'docker images | grep v0.30.0rc2'
ssh root@node1_ip 'docker images | grep v0.30.0rc2'
② 推送脚本(管理机执行,把四个脚本 + 补丁推到两节点):
cd /path/to/DeepSeek-V4.1-Flash   # 脚本所在目录
for IP in node0_ip node1_ip; do
  scp docker_run_node0.sh docker_run_node1.sh run_vllm_a2_node0.sh run_vllm_a2_node1.sh patch_allgather.py root@$IP:/root/
done
③ 创建容器(两节点各执行):
ssh root@node0_ip 'bash /root/docker_run_node0.sh'
ssh root@node1_ip 'bash /root/docker_run_node1.sh'
④ 打补丁(容器内执行,幂等,可重复跑):
ssh root@node0_ip 'docker cp /root/patch_allgather.py deepseek-v41-node0:/root/ && docker exec deepseek-v41-node0 python3 /root/patch_allgather.py'
ssh root@node1_ip 'docker cp /root/patch_allgather.py deepseek-v41-node1:/root/ && docker exec deepseek-v41-node1 python3 /root/patch_allgather.py'
# 预期输出:patch-ok(或 patch-already-applied)
⑤ 启动引擎(先 node0,90 秒后 node1):
ssh root@node0_ip 'docker cp /root/run_vllm_a2_node0.sh deepseek-v41-node0:/root/ && docker exec -d deepseek-v41-node0 bash -c "cd /root && nohup bash run_vllm_a2_node0.sh > /root/logs/vllm_node0.log 2>&1 &"'
sleep 90
ssh root@node1_ip 'docker cp /root/run_vllm_a2_node1.sh deepseek-v41-node1:/root/ && docker exec -d deepseek-v41-node1 bash -c "cd /root && nohup bash run_vllm_a2_node1.sh > /root/logs/vllm_node1.log 2>&1 &"'
⑥ 就绪轮询(约 14 分钟):
while true; do
  CODE=$(ssh root@node0_ip 'curl -s -o /dev/null -w "%{http_code}" -m 5 http://127.0.0.1:7000/health' 2>/dev/null || echo 000)
  echo "$(date +%H:%M:%S) health=$CODE"
  [[ "$CODE" == "200" ]] && break
  sleep 30
done
⑦ 冒烟验证:
# 模型信息(预期 id=deepseek-v4.1-flash-1017,max_model_len=1048576)
ssh root@node0_ip 'curl -s http://127.0.0.1:7000/v1/models'

# 中文推理
ssh root@node0_ip 'curl -s -m 120 http://127.0.0.1:7000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"deepseek-v4.1-flash-1017\",\"messages\":[{\"role\":\"user\",\"content\":\"用一句话回答:天空为什么是蓝色?\"}],\"temperature\":0,\"max_completion_tokens\":256}"'

# 工具调用(带 tools 参数)
ssh root@node0_ip 'curl -s -m 120 http://127.0.0.1:7000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"deepseek-v4.1-flash-1017\",\"messages\":[{\"role\":\"user\",\"content\":\"北京今天天气怎么样?\"}],\"temperature\":0,\"max_completion_tokens\":512,\"tools\":[{\"type\":\"function\",\"function\":{\"name\":\"get_weather\",\"description\":\"查询城市天气\",\"parameters\":{\"type\":\"object\",\"properties\":{\"city\":{\"type\":\"string\"}},\"required\":[\"city\"]}}}]}"'
# 预期 finish_reason=tool_calls,get_weather(city=北京)

# 停服(精确到容器名,勿用全局扫杀——会误伤同机其他推理容器)
ssh root@node0_ip 'docker rm -f deepseek-v41-node0'
ssh root@node1_ip 'docker rm -f deepseek-v41-node1'
5.3 脚本全文
docker_run_node0.sh(node1 版把 deepseek-v41-node0 全局换成 deepseek-v41-node1,其余一致):
#!/usr/bin/env bash
# 在 node0 上创建 DeepSeek-V4.1-Flash vLLM-Ascend 容器
set -euo pipefail

IMAGE=quay.io/ascend/vllm-ascend:v0.30.0rc2
MODEL_ROOT="/path/to/models"

docker rm -f deepseek-v41-node0 2>/dev/null || true

docker run -d \
  --name deepseek-v41-node0 \
  --net=host \
  --ipc=host \
  --shm-size=512g \
  --privileged=true \
  --device /dev/davinci0 \
  --device /dev/davinci1 \
  --device /dev/davinci2 \
  --device /dev/davinci3 \
  --device /dev/davinci4 \
  --device /dev/davinci5 \
  --device /dev/davinci6 \
  --device /dev/davinci7 \
  --device /dev/davinci_manager \
  --device /dev/devmm_svm \
  --device /dev/hisi_hdc \
  -v /usr/local/dcmi:/usr/local/dcmi \
  -v /usr/local/Ascend/driver/tools/hccn_tool:/usr/local/Ascend/driver/tools/hccn_tool \
  -v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
  -v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \
  -v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
  -v /etc/ascend_install.info:/etc/ascend_install.info \
  -v /etc/hccn.conf:/etc/hccn.conf \
  -v /path/to/dsv41_logs:/root/logs \
  -v "$MODEL_ROOT:$MODEL_ROOT" \
  "$IMAGE" \
  sleep infinity

echo "container deepseek-v41-node0 started on $HOSTNAME"
run_vllm_a2_node0.sh(node0 为 head,暴露 API;改编自官方 A2 四节点参考配置 DP4/TP8/EP32,本环境两机,按比例收缩为 DP2/TP8/EP16):
#!/usr/bin/env bash
set -euo pipefail

NODE_RANK=0
NODE0_IP="node0的实际IP"    # 替换为 node0 管理网 IP
LOCAL_IP="node0的实际IP"    # 替换为本机管理网 IP
NIC_NAME="实际业务网卡名"   # 替换为业务网卡名(两台可能不同)
MODEL_PATH="/path/to/models/DeepSeek-V4.1-Flash-1017-w8a8"

# 大模型权重加载 + 图捕获留足时间
export VLLM_ENGINE_READY_TIMEOUT_S="${VLLM_ENGINE_READY_TIMEOUT_S:-36000}"
export HCCL_IF_IP="$LOCAL_IP"
export GLOO_SOCKET_IFNAME="$NIC_NAME"
export TP_SOCKET_IFNAME="$NIC_NAME"
export HCCL_SOCKET_IFNAME="$NIC_NAME"
export ASCEND_RT_VISIBLE_DEVICES=0,1,2,3,4,5,6,7
# MRV2 在 rc2 上实测:V2 + 补丁 全链路验证通过;V1 为回退项。
# 无补丁时 V1/V2 均会在 warmup 阶段复现 #7606 (561000)。
export VLLM_USE_V2_MODEL_RUNNER=1
# 1M 长上下文 prefill 的 HCCL 算子超时保护(平台启动日志建议值)
export VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS=3000
[[ -f /usr/lib/aarch64-linux-gnu/libjemalloc.so.2 ]] && \
  export LD_PRELOAD="/usr/lib/aarch64-linux-gnu/libjemalloc.so.2${LD_PRELOAD:+:$LD_PRELOAD}"

HEADLESS_ARGS=()
if [[ "$NODE_RANK" != "0" ]]; then
  HEADLESS_ARGS+=(--headless --data-parallel-start-rank "$NODE_RANK")
fi

vllm serve "$MODEL_PATH" \
  --host 0.0.0.0 \
  --port 7000 \
  "${HEADLESS_ARGS[@]}" \
  --data-parallel-address "$NODE0_IP" \
  --data-parallel-rpc-port 13399 \
  --data-parallel-size 2 \
  --data-parallel-size-local 1 \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --served-model-name deepseek-v4.1-flash-1017 \
  --max-model-len 1048576 \
  --max-num-batched-tokens 4096 \
  --max-num-seqs 32 \
  --gpu-memory-utilization 0.90 \
  --block-size 128 \
  --tokenizer-mode deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --trust-remote-code \
  --model-loader-extra-config '{"enable_multithread_load":true,"num_threads":128}' \
  --safetensors-load-strategy lazy \
  --quantization ascend \
  --additional-config '{"enable_cpu_binding":true,"ascend_compilation_config":{"enable_npugraph_ex":false,"enable_static_kernel":false}}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":5,"enforce_eager":true}' \
  -cc '{"cudagraph_mode": "FULL_DECODE_ONLY"}'
run_vllm_a2_node1.sh:与 node0 版的差异只有三处——NODE_RANK=1、LOCAL_IP=""、NIC_NAME 换成本机业务网卡名;node1 以 headless 身份加入(DP rank 1),不暴露 API。
patch_allgather.py(#7606 的 workaround:背靠背双机组网下 MC2 dispatch 不支持,强制 MoE 通信走 ALLGATHER;幂等,可重复执行):
#!/usr/bin/env python3
"""Apply vllm-ascend#7606 workaround inside the container:
force MoE comm type to ALLGATHER for A2 back-to-back dual-machine topology
(MC2 dispatch op unsupported over back-to-back RoCE, ret=4 / 561000)."""
import io

P = "/vllm-workspace/vllm-ascend/vllm_ascend/ascend_forward_context.py"
RET = "    return moe_comm_type"
PATCHED = "    moe_comm_type = MoECommType.ALLGATHER\n    return moe_comm_type"

with io.open(P, "r", encoding="utf-8") as f:
    src = f.read()

if PATCHED in src:
    print("patch-already-applied")
else:
    new = src.replace(RET, PATCHED, 1)
    if new == src:
        raise SystemExit("patch-target-not-found")
    with io.open(P, "w", encoding="utf-8") as f:
        f.write(new)
    print("patch-ok")
5.4 启动参数:哪些是关键
| 参数 | 值 | 为什么 |
|---|---|---|
| --data-parallel-size 2 + --tensor-parallel-size 8 + --enable-expert-parallel | 2/8/EP | 双机全局 DP2/TP8/EP16。官方 A2 参考配置是四节点 DP4/TP8/EP32,本环境两台机器按比例收缩;node0 为 head 暴露 API,node1 headless |
| --max-model-len | 1048576 | 1M 上下文,与模型声明一致 |
| --quantization ascend | ascend | 走昇腾 W8A8 量化路径 |
| --tokenizer-mode / --reasoning-parser / --tool-call-parser + --enable-auto-tool-choice | deepseek_v41 | deepseek_v41 三件套,思考链解析和工具调用都靠它 |
| --model-loader-extra-config + --safetensors-load-strategy lazy | 128 线程 + lazy | 728G/138 分片权重的加载提速,冷启 14 分钟里加载约占 3 分钟 |
| --speculative-config | dspark,5 token,enforce_eager | DSpark 投机解码 |
| -cc '{"cudagraph_mode": "FULL_DECODE_ONLY"}' | — | 只对 decode 阶段做全图捕获 |
| --additional-config | CPU binding 开;npugraph_ex / static_kernel 关 | 后两个是待灰度项,本轮关闭 |
| --max-num-batched-tokens / --max-num-seqs / --gpu-memory-utilization | 4096 / 32 / 0.90 | 批大小、并发、显存水位;0.90 实测 HBM 92%/91% |
| --block-size | 128 | KV block 大小 |
5.5 验证清单(本轮全 PASS)
/v1/models:deepseek-v4.1-flash-1017,max_model_len=1048576- V2 runner 生效(日志
npu model runner v2) - 中文推理完整输出(finish=stop)
- 英文数学 2^10+24=1048 正确
- 工具调用
finish_reason=tool_calls+get_weather(city=北京) - 双节点 0 Traceback / 0 561000
- HBM 92% / 91%(0.90 配置正常水位)
- 服务指纹
vllm-0.30.0-tp8-dp2-ep-849b8c9f VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS=3000容器内在位
六、注意事项
- W8A8 本轮只做了功能验收:中文推理、英文数学、工具调用、长上下文响应质量判定正常;没有和 BF16 做逐项精度基准对比。对精度敏感的业务,建议用自己的数据重新验收后再上线。
- 多模态样本小:5 请求 1 张图,只看趋势,不下结论。
- 1M 是下限不是上限:扫描到 1,048,576 仍未失败,实际上限需要更大扫描上限才能逼近。
- A/B 对比口径:同机重部署、两版权重不同,所有对比结论按"镜像+权重组合"理解。
- 性能不评估智能:本文所有数据只反映吞吐/延迟/并发/容量,不代表模型能力排名。
- 可灰度项未开:
enable_npugraph_ex、enable_flashcomm1、enable_dsa_cp、enable_shared_expert_dp、multistream_overlap_shared_expert、engram(1017 权重暂无 engramfp8 目录)。要不要开、开了收益多少,是后面的事,老Q会持续更新。
一页结论
- 跑得通也跑得稳:DeepSeek-V4.1-Flash-1017 W8A8 在 2×Atlas 800 A2 双机(DP2/TP8/EP16 + vllm-ascend v0.30.0rc2)落地,1M 上下文实测扫满(≥1,048,576 tokens),98 请求 0 错误,已在生产运行。
- rc2 值得升:相比老镜像,单请求延迟 -12%、8 并发吞吐 +14%、32k 长上下文 ≈4.2×,TTFT 抖动消除;代价是 KV cache 每卡 -2.4%——账算得过来。
- 抄作业路径:第五节七步 + 四个脚本;补丁
patch_allgather.py必打;换镜像必须docker rm -f重建容器。
参考链接
- DeepSeek 官方公众号发布文(2026-10-17):https://mp.weixin.qq.com/s/X-5kbBkedQ5Oct9byUunag
- 权重下载:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017 | https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
- vllm-ascend v0.30.0rc1 release notes(DeepSeek V4.1 优化点主体):https://github.com/vllm-project/vllm-ascend/releases/tag/v0.30.0rc1
- vllm-ascend v0.30.0rc2 release notes(Dockerfile 修复):https://github.com/vllm-project/vllm-ascend/releases/tag/v0.30.0rc2
- vllm-ascend 官方模型文档(DeepSeek-V4.1-Flash):https://vllm-ascend-cn.readthedocs.io/zh-cn/latest/tutorials/models/DeepSeek-V4.1-Flash.html
- vLLM 官方博客《DeepSeek-V4.1-Flash on vLLM: 5x Agentic Throughput Since Day 0》:https://github.com/vllm-project/vllm-project.github.io/blob/main/_posts/2026-10-07-deepseek-v41-flash.md
数据来源:本文部署文档 v0.30.0rc2 版、性能测试报告(测试标准 v1.1)、新老镜像对比测试报告(2026-10-18);官方口径以 DeepSeek 公众号通稿和 vllm-ascend release notes 为准。全文已脱敏,脚本中 、、、/path/to/models 等占位符部署时替换为实际值。性能数据仅对本文所述拓扑与环境负责,换环境请以自有压测为准。为让大家第一时间适配,参数调优可能不够充分,欢迎大家留言交流。
本文转载自微信公众号「老Q」,仅供学习交流使用。
觉得内容不错?我要