
REA为何一夜爆火?软件行业真要完蛋?一份基于源码与社区证据的深度拆解(下)
本文来源: Kerry(公众号:Kerry)
原文链接: https://mp.weixin.qq.com/s/D8HPOjYRBcLJCoLKFBRO0Q
发布时间: 2026-10-14 21:05
作者: Kerry 发布时间: 2026-10-14 21:05
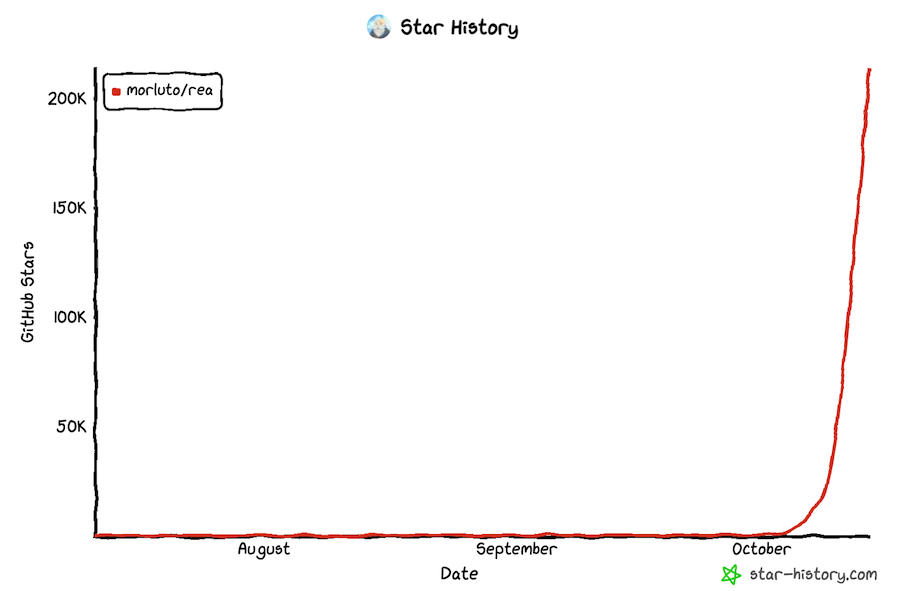
(继续火爆:2天,stars 从134.7k涨到227.1k,forks 从30.2k 涨到 56.4K, 增长超过70%)
【REA 爆火的真正原因,不是它造出了更强的反编译器,而是它把一个长达四十年、只有少数专家掌握的"逆向手艺",第一次变成了 LLM Agent 可以稳定调用的"标准能力",并用一整套证据纪律和工程护栏让这个能力变得可信、可复现、可规模化。】
REA为何一夜爆火?软件行业真要完蛋?一份基于源码与社区证据的深度拆解(上)
四. 架构设计优势:为什么它能"又快又稳地吞掉新能力"
REA 最被低估的,是它的架构选择如何支撑了商业上的"快"。下面从四个维度拆解。
1. Provider 抽象:把"引擎"变成可插拔的插槽
REA 支持多种深度分析引擎:Hopper、Ghidra、IDA、JEB,外加一大批内建/外挂的静态与运行时能力:
| 类别 | Provider / 能力 |
|---|---|
| 原生深度引擎 | Hopper、Ghidra(含 16-bit DOS、MIPS、NativeAOT、Windows P0)、IDA(GUI 附加 / 无头私有库)、JEB |
| 语言/格式内建 | Go 二进制(内建,无需 Go)、.NET 托管(静态,无需引擎)、WASM/WABT、EVM/EVMole |
| 打包与资源 | ZIP/APK/IPA/ASAR/DMG、Apple bundle 解剖、plist、PE 资源 |
| 移动端 | Android APK(JADX)、Apktool 资源、adb 设备、HarmonyOS HAP |
| 固件 | Binwalk / Unblob |
| 运行时观察 | 浏览器(CDP/Playwright)、Node Inspector、Electron、进程捕获(PTY)、mitmproxy/HAR 抓包 |
| 离线取证 | pwntools/pwndbg(ELF 布局、崩溃核心转储) |
关键在于 AnalysisProviderRegistry 的确定性选择策略:open_binary.provider_id 接受具体 ID 或 auto,歧义时要求显式选择,绝不静默 fallback。文档写得非常明确:
"Ambiguity and unknown, unavailable, or unsupported …"(选择必须确定,不猜测)
洞察点 7:很多工具会在引擎不可用时"悄悄降级",导致用户拿到质量不明的结果。REA 反其道而行——宁可报错让你选,也不悄悄降级。这与它的"证据纪律"一脉相承:降低不确定性优先于提升便利性。
2. 会话与证据账本:让"分析"成为一个可复现的对象
BinarySession + BinarySessionRecords + AnalysisSnapshotCache 构成了一个"不可变深度绑定 + 快照 + 证据账本"的模型:
- 一次分析绑定一个不可变的分析配置(profile)与其摘要;
- 大结果通过
inspect_analysis_view分页/摘要访问,不必把整图塞进模型上下文; - 证据可
export_evidence_bundle、可get_evidence_bundle,支持完整性校验(tamper/stale-input 检查); - 无头数据库不落盘(Ghidra/IDA 的 ephemeral 语义),不改可执行文件字节。
洞察点 8:这套设计直接回应了 Agent 场景的两个物理约束——上下文窗口有限 和 必须可复现。REA 设计了"摘要 + 引用 + 按需展开"的证据访问协议,而不是粗暴地把所有结果一次性推给模型。这是"为 Agent 原生设计"而非"给人类工具加个 MCP 壳"的典型区别。
3. 进程与所有权:把"脏活"变成领域概念
src/process/ 和 native/windows/ 把进程启动、超时、私有临时目录、有界文件读取、清理、Windows Job Object 提交限制等全部封装为有明确所有者的原语。AGENTS.md 里的原则极其专业:
"A PID and executable path alone do not establish ownership after exit or reuse."(仅凭 PID 和可执行路径,无法在进程退出或复用后确立所有权。)
这直接避免了大量 AI 工具常见的"僵尸进程、临时文件泄漏、误杀无关进程"问题。
4. 契约与边界守卫:让"多人/多引擎协作"不失控
src/contracts/
定义面向调用方的 schema(输入/输出),并与运行时校验严格一致;
- 生成式产物(MCP 工具目录、产品目录、错误 schema、技能元数据)都有
--check模式,禁止手改生成物; verify:module-boundaries
/ verify:architecture-guards 在 CI 强制依赖方向;
- 对 Kimi/Moonshot 这类"单工具 schema 有硬大小上限"的客户端,提供
compact输入 schema 方案(13,312 字节预算),在保证服务端完整校验的前提下适配客户端怪癖。
洞察点 9:这一层几乎全是"防自己人犯错"的设计。当一个项目的增长速度远超人员增长速度时,唯一能保证不崩的,就是这种把经验固化成编译期/CI 期约束的能力。 REA 的架构本质上是"可扩展的秩序"。
五. 功能特性创新清单
以下是与"传统逆向工具+手动流程"和"朴素Ghidra-MCP"的对比,突出REA的差异化功能:
| 维度 | 传统方式 | 朴素Ghidra-MCP | REA |
|---|---|---|---|
| 使用姿势 | 学逆向、装工具、啃 API | Agent 调 Ghidra 函数 | 自然语言提问 → 证据化结论 → 生成代码 |
| 能力范围 | 单一引擎 | 单一引擎 | 9 大类目标、多引擎可插拔 |
| 证据 | 人脑记忆 | 无 | Evidence ID + 观察/推断/未知 + 覆盖声明 |
| 可复现 | 靠人 | 否 | 会话绑定 + 快照 + 证据导出/校验 |
| 大结果处理 | — | 直接爆上下文 | 摘要/分页/按需展开 |
| 运行时观察 | 手写脚本 | 无 | 浏览器/Electron/进程/抓包被动观察 |
| 版本对比 | 手工 | 无 | compare_application_versions 生成变更报告 |
| 合规边界 | 自己把握 | 无声明 | 本地、只读、BYO、不装无关软件、明确免责 |
| 客户端适配 | — | 个别 | 15+ Agent 客户端 + compact schema |
| 首次成功门槛 | 极高 | 中 | 低(静态 JS/Electron 零引擎可跑) |
几个值得一提的具体创新:
- 技能与工具双交付:MCP 提供"手",skill 提供"脑"(工作流指令)。
- 确定性 Provider 选择:歧义要求显式选择,绝不静默降级。
- 运行时与静态的"对账":既可静态读 JS/Electron,也可被动观察真实运行时,并支持两者对照(static/runtime reconciliation)。
- 重建就绪度(reconstruction readiness):有
evaluate_reconstruction_coverage、build_reconstruction_obligation_ledger等工具,把"是否具备重建条件"变成可量化问题。 - "Oracle 驱动"的重建方法论:官网 DX-Ball 案例宣称重建代码通过 3,205 个原始 x86 用例,并逐字节复现全部 63 个编译函数字节——这是"用参照物做裁判"的极致工程。
六. 冷静的批判:哪些是真突破,哪些是叙事放大
一份有洞察的报告不能只唱赞歌。以下是需要泼冷水的部分。
1. "闭源护城河破产"被夸大了
- 代码可复制 ≠ 生意可复制。 InfoQ 文章里徐昊、阎志涛的观点值得重读:"克隆能拿走的是代码,拿不走的是知识""如果源码一旦可以获得,软件生意就无法继续,那开源软件的商业模式早就应该不存在了。"
- Red Hat 是最好的反例:代码全开放,企业仍愿意为"生产级软件、生命周期管理、兼容性、补丁更新、技术支持"付费。客户买的从来不只是那份代码。
- 护城河不是消失,而是迁移:从"你看不到我的代码"迁移到"你拿不走我的服务能力、客户关系和业务理解"。
本报告观点:REA 真正击穿的,是"信息不透明"型护城河(靠代码藏起来制造的稀缺)。它对"实现难度"型护城河的削弱是真实且重大的,但对"服务与信任"型护城河几乎无效。因此,"软件完蛋了"是三成真相、七成情绪。
2. Star 通胀与营销因素无法排除
- 134.7k star / 30.2k fork 是事实,但开源世界的 star 早已通胀,项目热度也可能受算法推荐、社群动员、媒体放大器影响。
- 值得肯定的是:REA 的 fork 与 commit 数同样高,这大幅削弱了"纯刷量"的怀疑。它至少是"真被大量人实际使用和二次开发"的。
3. 证据 ≠ 正确
REA 的证据纪律极大提升了可信度,但必须清醒:"可追溯"不等于"正确"。反编译伪代码可能错误,证据可能自洽却指向错误结论。DISCLAIMER 自己也承认:
"Decompilation, reconstruction, heuristics, and AI-assisted analysis may be incomplete or incorrect."
4. 法律与伦理灰区真实存在,且被"技术性规避"而非"消除"
- REA用"本地运行 + BYO商业工具 + 只读 + 不装无关软件 + 强免责声明"构建了合规外壳;
- 但"克隆别人软件的功能"在很多法域可能触及著作权、不正当竞争、DMCA/EULA 等红线;
- README 明确声明不支持绕过 DRM/授权/反作弊,也不授权使用破解版商业工具(IDA/Hopper/JEB 必须合法获得)。
- 免责声明能降低项目方风险,却不能替使用者免除法律责任。 这是每一个使用者必须自担的部分。
5. 对商业工具生态的隐性依赖
深度原生分析依赖 Hopper/Ghidra/IDA/JEB。Ghidra 是 NSA 开源(免费),但 Hopper、IDA、JEB 都是商业工具。因此 REA 的"最强能力"对普通用户并非完全免费可获得——这是一个被 star 数掩盖的现实门槛。
七. 对行业的启示
- MCP 正在成为"AI 时代的 USB-C",而最大的机会在"重型专业工具"的编排层。 REA 证明了:不需要重造引擎,谁先把专业能力"Agent 化"并解决可信度问题,谁就吃到红利。
- 在 AI 产品里,可信度工程 > 能力工程。 让模型更强是通用赛道的竞争;把结果做成"可追溯、可复现、区分已知未知",才是垂直产品的差异化壁垒。
- 开源增长的黄金公式 = 硬技术事实 × 强情绪叙事 × 极低首次成功门槛。 REA 三者齐备:能真跑(事实)、"软件完蛋了"(叙事)、一行 npx 且零引擎可跑(门槛)。
- 软件的价值逻辑正在重构:从"实现难度/信息不透明"转向"业务理解/服务响应/长期保障"。 当代码和功能越来越易复制,定价权必然向"拿不走的东西"迁移——这对真正懂行业的 know-how 型团队反而是机会。
- 合规姿态不是成本,是增长杠杆。 REA 的"本地、只读、BYO、逐项审批"设计,让它在敏感领域也能被媒体、企业、社区接纳而不被下架或污名化。
结论
REA的火爆,表面是"Agent能克隆一切软件"的惊悚叙事,底层却是一次教科书级的"专业能力Agent化"实践:
- 它没有发明反编译器,而是发明了 AI 与逆向引擎之间的可信编排层;
- 它没有追求模型更强,而是用 Evidence 语义 解决了 AI 逆向最致命的信任问题;
- 它没有靠营销起量,而是把 工程严谨、分发体验、合规边界 全部产品化;
- 它踩准了 编码 Agent 主流化 + MCP 标准化 的双重时机。
"闭源护城河破产"言过其实,但"代码将越来越不构成稀缺"是真实趋势。REA 不是软件的末日,而是软件价值定价逻辑迁移的一座路标:能被复制的会越来越便宜,能建立信任与服务的会越来越值钱。
对于开发者和产品人,最该从 REA 身上学到的不是"怎么克隆软件",而是它证明的那条通用规律——
在 AI 时代,把一个领域的"专家手艺"转化为"Agent 可信可用的能力",其价值可能远超领域本身。
本文转载自微信公众号「Kerry」,仅供学习交流使用。
觉得内容不错?我要