
本地跑通"破限版"Qwen Image 2.1:14 秒一张
本文来源: Coder建设(公众号:Coder建设)
原文链接: https://mp.weixin.qq.com/s/MCrr3YxBpORJMmcyVPzhVw
发布时间: 2026-10-01 07:10
作者: Coder建设 发布时间: 2026-10-01 07:10
实测复盘 · 本地部署 · ComfyUI · Qwen-Image-2.1 · Heretic
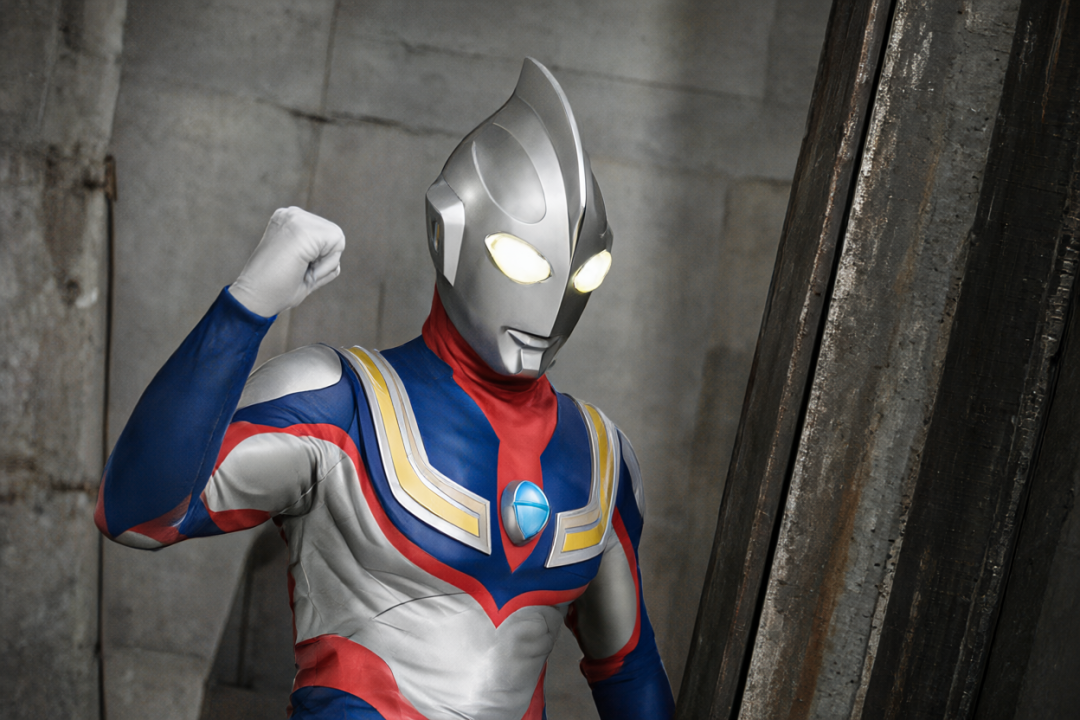
奥特曼,本地破限版直出,1248×832(本文所有配图均为本地实测生成,图源:作者实测)
| 14.0s/张
1248×832 热身后,RTX 5060 Ti 实测 | | 14.3GB
破限"四件套"磁盘总占用 |
| :----------------------------------------------: | - | ----------------------------------------------------------- |
| 40 → 6
蒸馏 LoRA 把采样步数压到 6 步 | | 100% → 5%
Heretic 破限后提示词拒绝率(社区数据) |
社区"破限版"Qwen Image 2.1(Heretic 方案)+ 六步蒸馏 LoRA,在一张 16GB 的 RTX 5060 Ti 上做到了约 14 秒一张 1248×832——IP 角色这类"云端平台不敢画"的内容,本地直接出图。代价也很清楚:细节质感偏软、次要主体会崩(本文有翻车实拍),以及所有内容风险完全转嫁到使用者自己身上。
用过大厂文生图服务的人都有过这种体验:想画一个奥特曼手办、一张影视角色的同人图,提示词刚发出去就弹出"内容不符合规范"。这些拦截多数和违法无关,而是平台的版权与合规策略——宁可错杀,不能担责。
Qwen Image 2.1 是阿里开源的图像生成模型,权重就挂在 Hugging Face 上。但官方版本的文本编码器经过了安全对齐训练,对"敏感"提示词会往"拒绝"方向走,表现为出图偏离描述、质量劣化。社区的处理方案叫 Heretic:对文本编码器做"消融",直接移除模型内部的拒绝方向。配合量化和无审查版本的主模型,就成了本文实测的"破限四件套"。
我在 RTX 5060 Ti 16GB 上把整套东西跑通了,用了三天,画了三十多张图。这篇文章把部署过程、真实速度、成功与翻车的案例全部摊开来讲。
01 "破限"到底破了什么
先澄清一个误区:"破限"不是往模型里注入什么神秘代码,而是三层过滤拆了两层。文生图的 内容管控大致分三层:云端平台的内容策略(法务合规)、服务端安全过滤器(模型输出后的机器审核)、模型内部的安全对齐(训练时写入的"拒绝本能")。本地部署天然消灭了前两层——没有平台、没有服务端,剩下的第三层就是 Heretic 的活儿。
Heretic 是一个开源的"去审查"工具,原本用于大语言模型,思路是消融(abliteration):在模型的激活空间里找到"拒绝方向"这个向量,然后把它从权重里投影掉——模型不再"学会"拒绝,而是物理上失去了拒绝的能力。社区把这套方法用在了 Qwen Image 2.1 的文本编码器(Qwen3-VL 8B)上,按项目自报的数据,提示词拒绝率从 100% 压到了 5%(注:此为社区数据,本文未做官方版 A/B 对照,但从实测看,破限版对提示词的服从度确实非常高)。
一个容易被忽略的细节:VAE(变分自编码器)不参与内容判断,官方原版直接用,不用换;而"提示词增强"这类原版对齐组件反而要离它远点——增强器走的是官方对齐过的提示词风格,等于把"审查本能"从后门请回来。
02 破限四件套与部署实录
整套部署基于 ComfyUI 0.38.0 便携版(Windows),四个模型文件放对目录即可,总计约 14.3GB:
| 组件 | 文件 | 大小 / 说明 |
|---|---|---|
| 生图主模型 | qwen-image-2.1-Q8_0.gguf | 7.1GB,社区无审查量化版,SHA256 已校验 |
| 文本编码器 | qwen3vl_8b_nvfp4_heretic | 5.9GB,Heretic 破限版,NVFP4 格式(50 系卡原生 FP4 加速) |
| VAE | qwen_image_2.1_vae_bf16 | 645MB,官方原版 |
| 加速 LoRA | viggle-turbo-6step-r128 | 649MB,六步蒸馏,40 步压到 6 步 |
部署本身不难——模型放对文件夹、工作流拖进 ComfyUI 就能出图。真正的时间都花在踩坑上,最典型的一个:
⚠ 踩坑警告:ComfyUI 0.38 在 Windows 上的异步权重加载有 bug,模型加载阶段直接报 GetOverlappedResult error 1450 后挂死。解法是启动参数加 --disable-async-offload,让权重回退为同步加载。不加这个参数,服务根本起不来;加错位置也不行,必须是主程序参数。这个坑搜英文关键词都未必能搜到中文解法,建议直接抄。
ComfyUI 原生界面拖节点毕竟麻烦,我顺手用插件机制给部署加了一层"皮":一个自建的极简生图页面(qwen_studio),提示词、尺寸、参考图、历史记录都在一页上,家里人也能用:
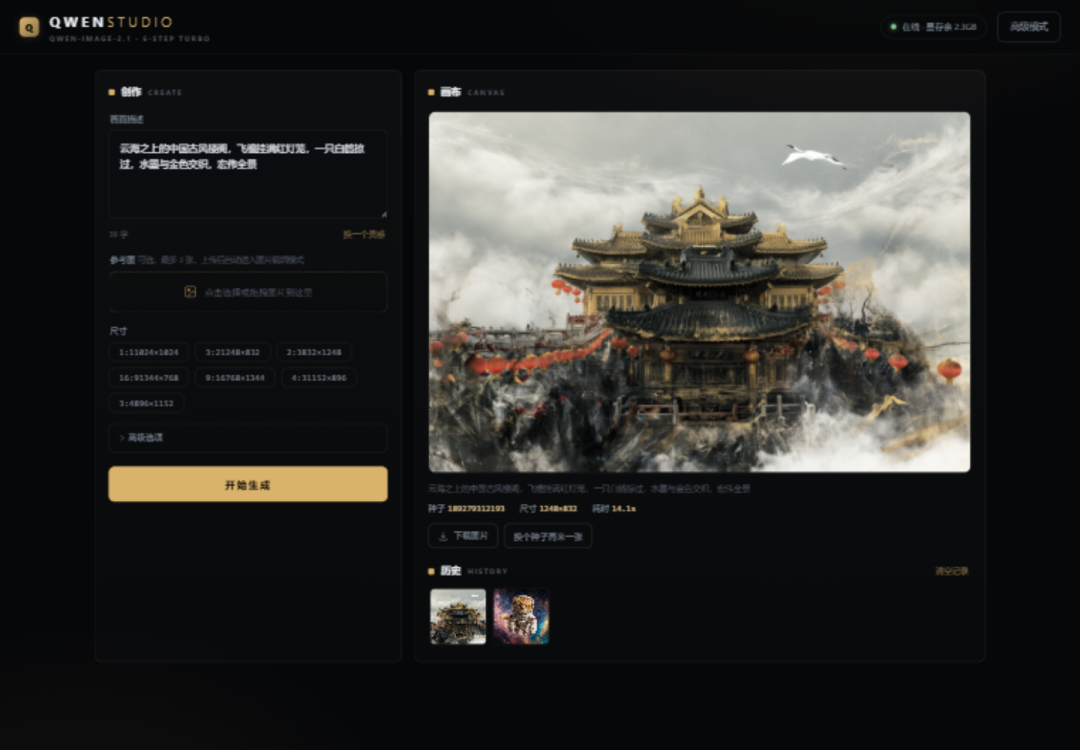
自建 qwen_studio 生图页面,右上角实时显示显存占用(图源:作者实测截图)
03实测一:文生图基本功与中文招牌
先看基本功。提示词:"一只穿小雨衣的小熊猫,撑着绿叶伞站在雨中竹林,电影感写实照片"——1248×832,六步采样,热身后 14.0 秒出图。毛发的湿润质感、雨滴的通透感都在线,构图完全按提示词走:
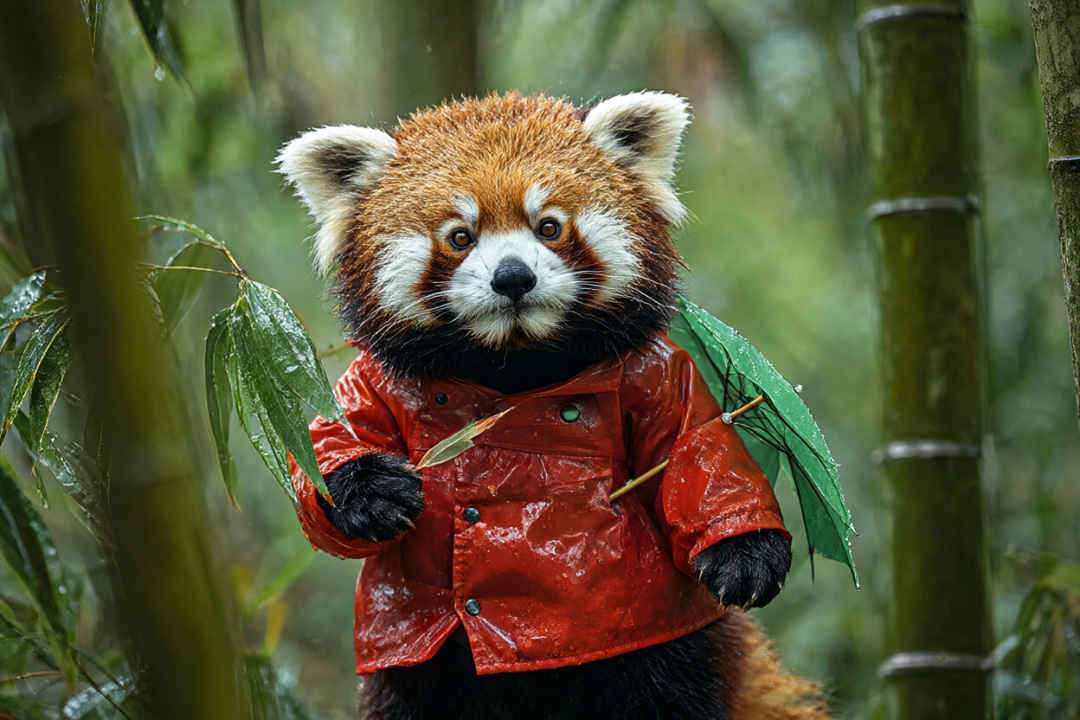
文生图实测:小熊猫雨衣,14.0s 直出(图源:作者实测)
Qwen 系列的招牌能力是中文文字渲染,这也是它对比国外模型最大的差异化卖点。实测一块中式茶馆匾额,要求"「青云茶舍」四个烫金楷书大字"——四个字全部零错字,笔画结构、金漆质感、匾额的悬挂透视都对,这个水平放在闭源服务里也是第一梯队:
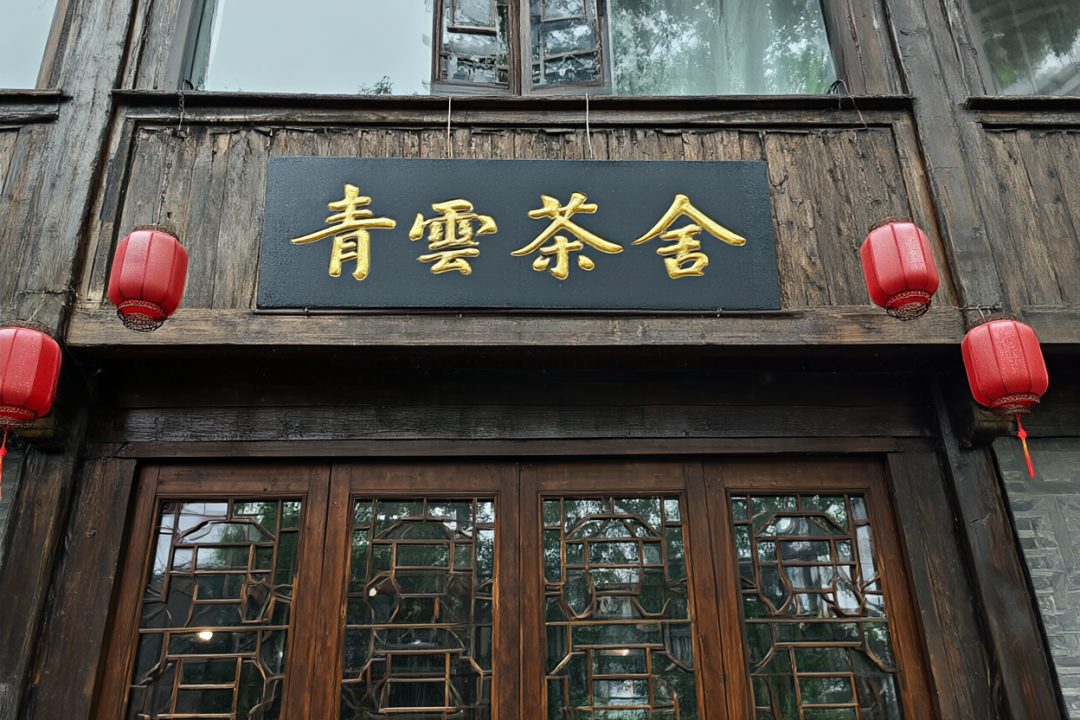
中文文字渲染实测:「青云茶舍」零错字,14.3s(图源:作者实测)
04 实测二:"破限"名场面——IP 角色直出
本文首图那张奥特曼就是破限版的日常:提示词写"奥特曼站在废墟中摆出战斗姿势,写实皮套质感",直接出图,没有拦截、没有提示词被偷偷改写。同类 IP 提示词在主流商用文生图服务上基本都会触发内容拦截——这是"破限"最直观的使用场景差异。
需要说清楚的是:云端平台拦 IP 内容,拦的主要是版权风险,不是模型画不出来。破限版解决的是"本地无拦截",不改变生成 IP 内容在法律上的版权属性——商用、传播的后果依然由使用者承担。这一点后面合规部分还会展开。
05 实测三:编辑模式——"把红雨衣改成蓝色"
Qwen Image 2.1 原生支持图像编辑:把参考图拖进来,用自然语言下指令。我把上面那张小熊猫喂回去,指令就一句:"把红色雨衣换成蓝色雨衣,其余保持不变"。结果相当干净——雨衣变成了蓝色,其余元素(竹林、伞、姿势、雨滴、甚至胸口的叶子和雨衣上的水光)全部保留:
原图
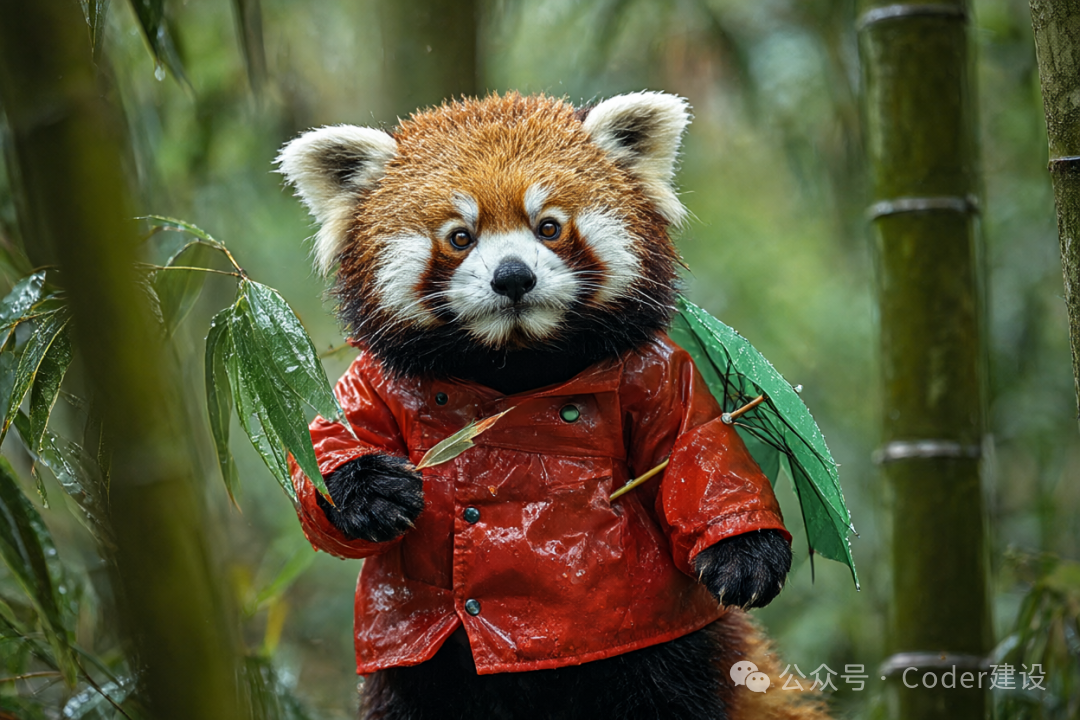
编辑后:"换成蓝色雨衣"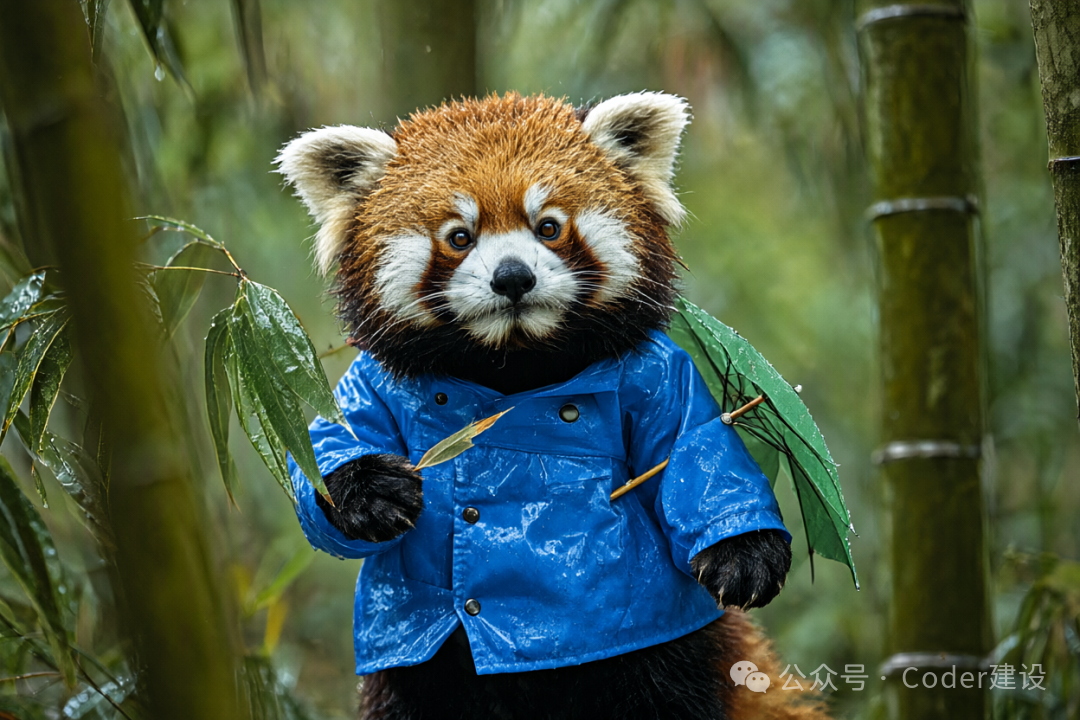
编辑模式实测:单指令换色,其余元素保持(图源:作者实测)
一个实测发现的细节:编辑模式比文生图慢不少——文生图约 14 秒,编辑约 24 秒。原因是参考图会作为图像条件进入文本编码器和扩散过程,计算量明显增加。另外编辑模式的尺寸自动跟随参考图,不用手动指定。
06 实测四:能力边界——能扛多刁钻的提示词
我设计了一组"刁难型"提示词,专门测六步蒸馏模型的短板,结果一半出乎意料:
| 测试项 | 提示词要点 | 结果 |
|---|---|---|
| 数量计数 | 三只小熊猫,各戴不同颜色的帽子 | ✅ 三只三色,全对 |
| 空间关系 | 瓷杯放桌子左缘,剪刀放杯子右边 | ✅ 左右关系正确 |
| 多约束组合 | 四只熊猫:红帽/无帽/绿帽/捧蓝杯 | ✅ 四项约束全满足 |
| 人手精细动作 | 钢琴家双手十指按琴键 | ❌ 前景尚可,背景手部崩了 |
四只熊猫的多约束组合一次性全对,说实话超出预期——"从左数第二只不戴帽子"这种否定式约束是很多大模型都栽的坑。但翻车也翻得很典型:钢琴家那张图,前景的手勉强能看,背景里的手完全糊掉,手指融成了一团。放大看更明显:
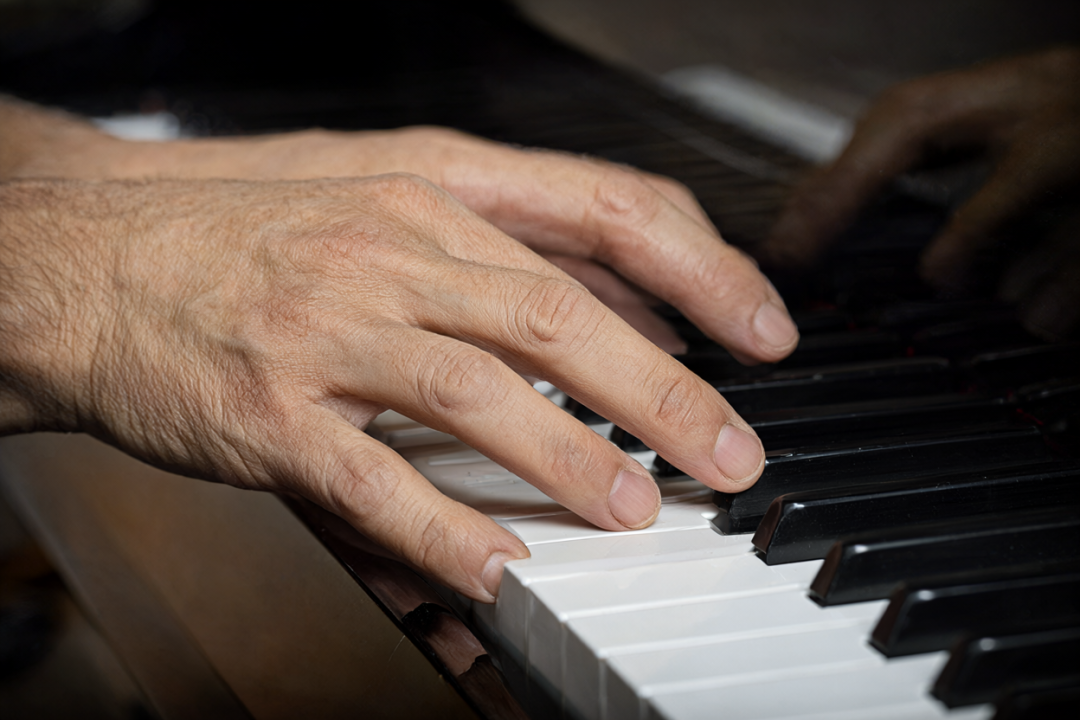
失败案例:钢琴家双手,注意右上角背景的手(图源:作者实测)
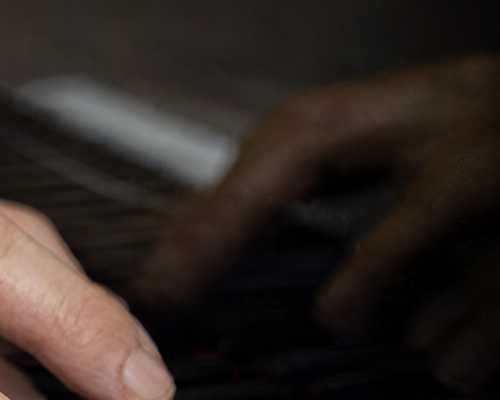
背景手部放大:手指融合,六步采样的典型短板(图源:作者实测)
这不是破限的问题,是六步蒸馏的代价:采样步数从 40 步压到 6 步,速度换来的是细节打磨次数的骤减。次要主体、精细纹理(发丝、皮肤质感)明显偏软,复杂手部直接崩。蒸馏模型也没有 CFG 和负面提示词可用,想靠负面词兜底都做不到。如果对画质有更高要求,可以换回完整版工作流(40 步,约 90 秒/张),或者关掉 LoRA——显存够的话这是更平衡的选择。
07 性能数据汇总
| 指标 | 实测值(RTX 5060 Ti 16GB) |
| 文生图速度(1248×832,热身后) | 13.86 – 14.34s/张,均值约 14.0s |
| 编辑模式速度(参考图条件) | 23.9 – 24.3s/张,均值约 24.1s |
| 冷启动首张(含模型加载) | 约 24 – 34s |
| 显存占用 | 峰值约 13.8 / 16GB,主模型完整常驻 |
| 采样配置 | 6 步,euler,无 CFG / 无负面提示词 |
| 磁盘占用(四件套合计) | 约 14.3GB |
补充两句配置判断:8GB 显存的卡也能跑(GGUF 分层加载会吃掉一部分速度优势,预计 25 – 40 秒/张);12GB 是舒适线;16GB 可以让主模型完整常驻、换来 14 秒的流畅体验。显卡驱动需要 580 以上版本(50 系 NVFP4 文本编码器的前提)。
08 必须说清楚的合规边界
⚠ 能生成 ≠ 可以生成。破限移除的是模型的技术能力限制,不是法律限制。
合法但受限的内容(IP 同人、艺术创作等)本地生成的风险主要是民事的:版权侵权与人格权纠纷,责任同样由使用者承担。换句话说,破限版把"平台替你把关"变成了"你自己对自己负责"——这正是它自由和危险同源的地方。本文的定位是技术评测:怎么跑起来、跑多快、边界在哪,都在上面了;至于拿它画什么,那是每个使用者自己的答卷。
09 总结:适合谁,不适合谁
这套方案适合:被云端平台内容策略反复误伤的创作者(IP 同人、概念设计)、想要数据完全不出本地的专业用户、以及喜欢折腾本地工作流的技术玩家。14 秒一张的出图速度配 16GB 显存的门槛,在 2026 年的消费级硬件上已经是"顺手就用"的水平。
不适合:追求极致画质细节的商业出图(六步蒸馏的质感上限摆在那里)、没有独立显卡的轻薄本用户、以及——直说吧——指望用它生成违法内容还不用负责的人。技术上它确实"什么都能画",但法律上,有些东西画了就是要进去的。模型已经没有闸门,闸门只剩你自己的判断力。
本文转载自微信公众号「Coder建设」,仅供学习交流使用。
觉得内容不错?我要