
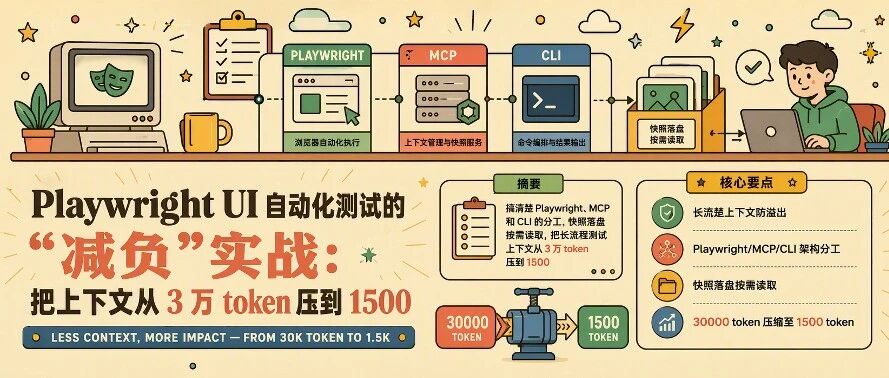
Playwright UI 自动化测试的“减负”实战:把上下文从 3 万 token 压到 1500
本文来源: 未署名(公众号:未署名)
原文链接: https://mp.weixin.qq.com/s/Of35GpLnvwucnvV7MM5LYQ
发布时间: 2026-09-12 16:52
作者: 未署名 发布时间: 2026-09-12 16:52
导语:长流程 UI 测试最怕的不是“不会点浏览器”,而是十几个页面还没跑完,上下文就已经顶满。这篇文章带你搞清楚 Playwright、MCP 和 CLI 的分工,把快照落盘、按需读取,真正给测试“减负”。
一、长流程 UI 测试,为什么容易把上下文撑爆?
电商下单、ERP 审批这类长流程,页面多、状态复杂。很多团队一开始用 Playwright MCP,感觉很惊艳:Agent 能直接 browser_navigate、browser_click,短期探索页面很爽。
但丢进真实业务回归时,痛点很快露出来:一次导航就可能把可访问性快照和工具 Schema 全量塞进上下文。复杂任务还没跑完,上下文就已经触顶了。
这不是个例。Playwright MCP 的 GitHub Issues 里,开发者反馈:复杂页面的快照从 50KB 到 540KB 不等,2-3 次导航就会导致上下文溢出(HTTP 413 “Prompt is too long”)。有团队被迫完全禁用 Playwright MCP 工具来避免报错。
更关键的是:UI 自动化最贵的不是“多写几条用例”,而是把完整页面状态反复灌进模型。旧状态不断累积,后面的断言、截图、失败定位都会被挤掉。测试团队要的是可重复、可回放、可进 CI 的回归能力。上下文一爆,用例就中途停摆,缺陷证据也留不全。
二、先搞清楚:Playwright、MCP、CLI 各管什么?
Playwright 是微软开源的 Web 自动化框架,用代码控制浏览器,模拟真实用户操作。它是 MCP 和 CLI 共同的底层引擎。
Playwright MCP 是微软维护的 MCP Server,把 Playwright 能力封装成二十多个可调用工具。它的设计逻辑是:每次操作后自动生成页面快照,并全量灌入上下文。适合短期探索,但长流程会迅速耗尽 token。
Playwright CLI 走的是另一条路:快照和截图落盘到文件,AI 按需读取。状态存在磁盘上,而不是堆积在对话历史里。
有开发者做过实测对比:同一个浏览器自动化任务,CLI 模式消耗约 27,000 tokens,MCP 模式约 114,000 tokens,相差 4 倍。而且随着步骤增加,差距会从 4 倍拉大到 10 倍。
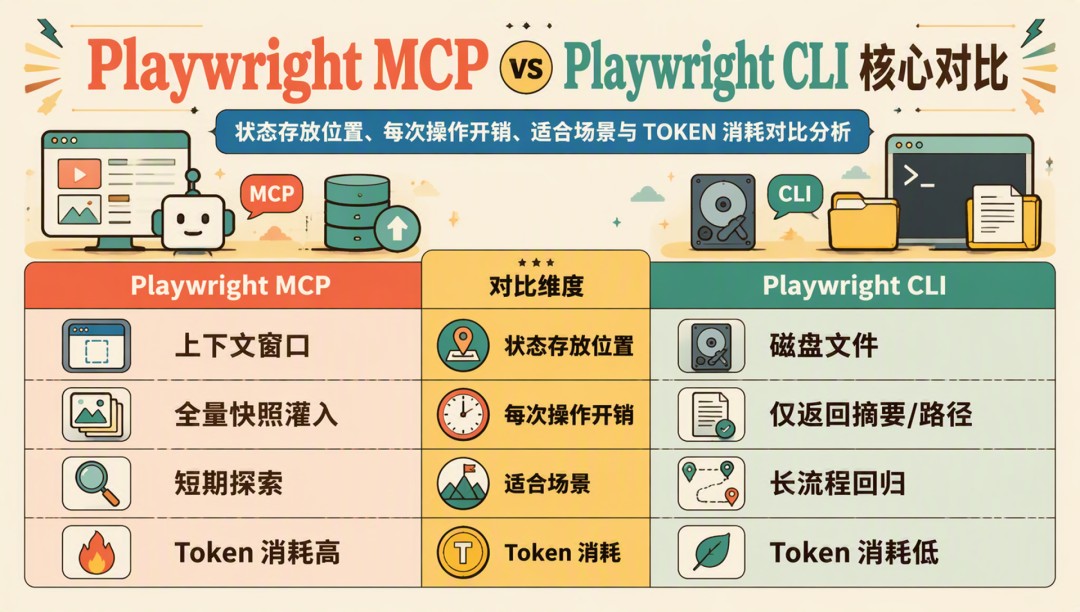
| 维度 | Playwright MCP | Playwright CLI |
|---|---|---|
| 状态存放位置 | 上下文窗口 | 磁盘文件 |
| 每次操作开销 | 全量快照灌入 | 仅返回摘要/路径 |
| 适合场景 | 短期探索、简单页面 | 长流程回归、CI 集成 |
| Token 消耗 | 高(4-10 倍) | 低 |
| 可审计性 | 观察与推理混在一起 | 快照文件独立可查 |
三、实战:把上下文从 3 万压到 1500
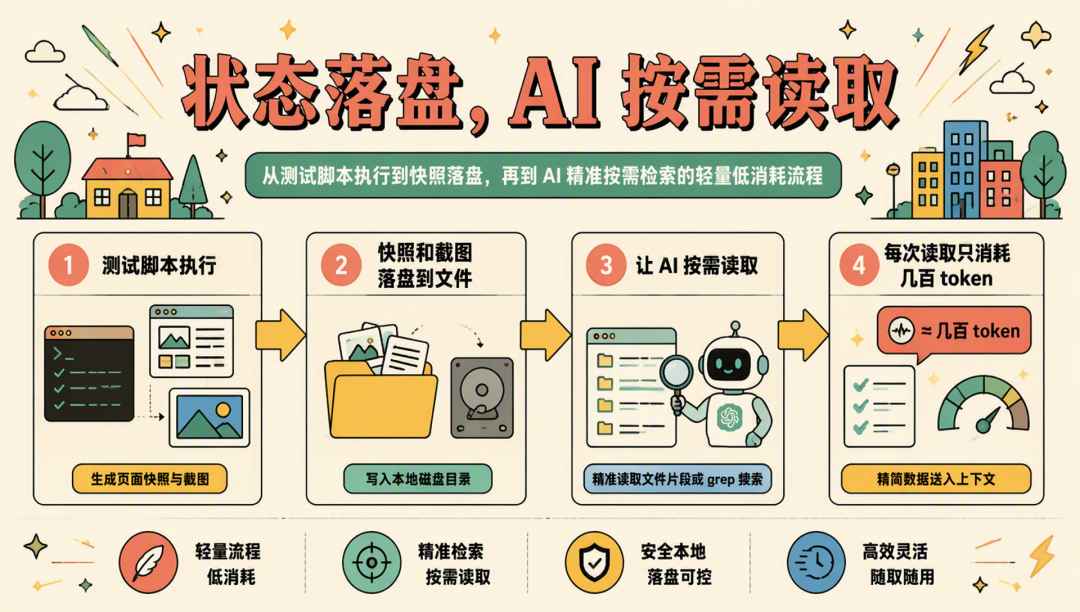
核心思路:状态落盘,AI 按需读取
不要把所有页面状态都塞进模型。让快照和截图落到磁盘,需要时再用文本搜索或指定范围读取。
3.1 安装 playwright-cli
首先确保项目里安装了 Playwright:
npm init playwright@latest或者直接安装 CLI 工具。
3.2 配置 MCP(可选,用于探索阶段)
如果还需要 MCP 做短期探索,可以在 Codex 的 MCP 配置里加上:
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["-y", "@playwright/mcp@latest"]
    }
  }
}但关键策略是:长流程测试优先用 CLI,MCP 只留给探索性任务。
3.3 让快照落盘
在测试脚本里,把 page.screenshot() 和 page.accessibility.snapshot() 的输出写到指定目录:
const fs = require('fs');
const path = require('path');

const OUTPUT_DIR = './test-artifacts';

test('checkout flow', async ({ page }) => {
  await page.goto('https://example.com/cart');

  // 快照落盘,不进上下文
  const snapshot = await page.accessibility.snapshot();
  fs.writeFileSync(
    path.join(OUTPUT_DIR, 'cart-snapshot.json'),
    JSON.stringify(snapshot, null, 2)
  );

  // 截图落盘
  await page.screenshot({
    path: path.join(OUTPUT_DIR, 'cart-page.png'),
    fullPage: true
  });

  // 继续操作...
});
3.4 让 AI 按需读取
当测试失败或需要断言时,告诉 Codex/Agent 只读取需要的文件片段:
“读取 test-artifacts/cart-snapshot.json 中 ref 为 e343 的元素信息”或者用 grep 搜索关键内容:
grep -A 5 "结算按钮" test-artifacts/cart-snapshot.json这样每次读取只消耗几百 token,而不是几万。
四、实测数据:差距有多大?
有开发者分享了一个典型场景的对比:
| 场景 | 原始大小 | 压缩后 | 节省比例 |
|---|---|---|---|
| Playwright 快照 | 56KB | 299B | 98% |
| 20 个 GitHub Issues | 59KB | 1.1KB | 98% |
| 500 条访问日志 | 45KB | 155B | 99% |
一个典型的长流程 UI 测试:
- • MCP 模式:3 万+ tokens,约 6-8 步就触顶
- • CLI + 落盘模式:1,500 tokens 左右,可跑完整流程
这意味着:测试从“跑一半就崩”变成了“可稳定回归”。
五、进阶方案:Context Mode 思路
如果不想手动管理落盘和读取,有一个开源方案叫 Context Mode,它在 AI 工具和输出之间加了一个中间层:
- 沙箱隔离执行:工具调用在独立子进程里跑,原始输出留在沙箱内,只有精简结果返回模型
- SQLite + BM25 索引:Markdown 内容建索引,需要时精准拉取相关片段
这个思路的核心是:不要让原始大块数据进入上下文窗口。Playwright 快照从 56KB 压到 299B,就是靠这个机制。
六、总结
Playwright MCP 适合短期探索,Playwright CLI 适合长流程回归。
减负的关键不是“少写用例”,而是改变状态存放的位置——从上下文窗口搬到磁盘文件。
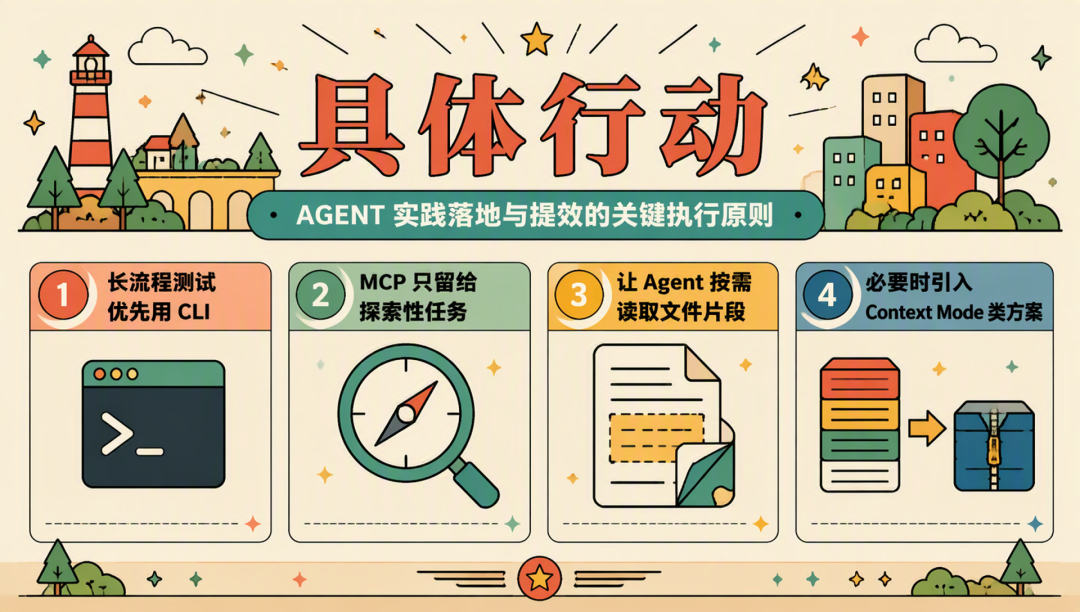
具体行动:
- 长流程测试优先用 CLI,快照截图落盘
- MCP 只留给探索性任务,用完即走
- 让 Agent 按需读取文件片段,而不是全量灌入
- 必要时引入 Context Mode 类方案,自动压缩输出
把上下文从 3 万压到 1500,意味着你的 UI 自动化终于可以跑完整个流程、留下完整证据、进入 CI 流水线。
七、资料领取
如果你想系统学习 Codex + Playwright 做 UI 自动化测试,或者想拿到文中提到的完整配置文件和实战脚本,可以关注留言:
如果这篇文章对你有帮助,欢迎点赞、在看、转发三连,让更多测试同行看到~
本文转载自微信公众号「未署名」,仅供学习交流使用。
觉得内容不错?我要