
vLLM 是如何工作的?
本文来源: AI灰鲸(公众号:AI灰鲸)
原文链接: https://mp.weixin.qq.com/s/rvIZDxpi1eXP_R930pWcAg
发布时间: 2026-10-17 10:55
作者: AI灰鲸 发布时间: 2026-10-17 10:55
vLLM 是一个用于大语言模型推理服务的高吞吐引擎。它通过 PagedAttention(分页注意力)高效管理 KV 缓存占用的显存,从而在同一张 GPU 上同时服务更多用户。
这篇文章将介绍 vLLM 的工作原理,为什么需要它,它如何巧妙地管理显存,以及实际系统如何用它同时为大量用户提供大语言模型服务。
01•什么是大语言模型推理服务?
讨论 vLLM 之前,先弄清楚:为大语言模型提供服务,究竟是什么意思。
大语言模型(Large Language Model,LLM)是 ChatGPT、Claude 等工具背后的技术。输入一段文本,它就返回一段文本。
提供大语言模型推理服务,就是让模型在计算机上运行,使许多用户能够同时向它提问并获得回答。
简单说,这一过程负责接收用户请求,交给模型处理,再把回复发送回去。
假设开发了一个聊天助手,数千人同时打开它,每个人都输入一个问题。所有问题一起到达模型,而每个人都希望快速得到回答。负责接收这些请求、为每个请求运行模型并返回相应回复的软件,就叫作推理服务引擎(serving engine)。
这个流程可以用下图表示:
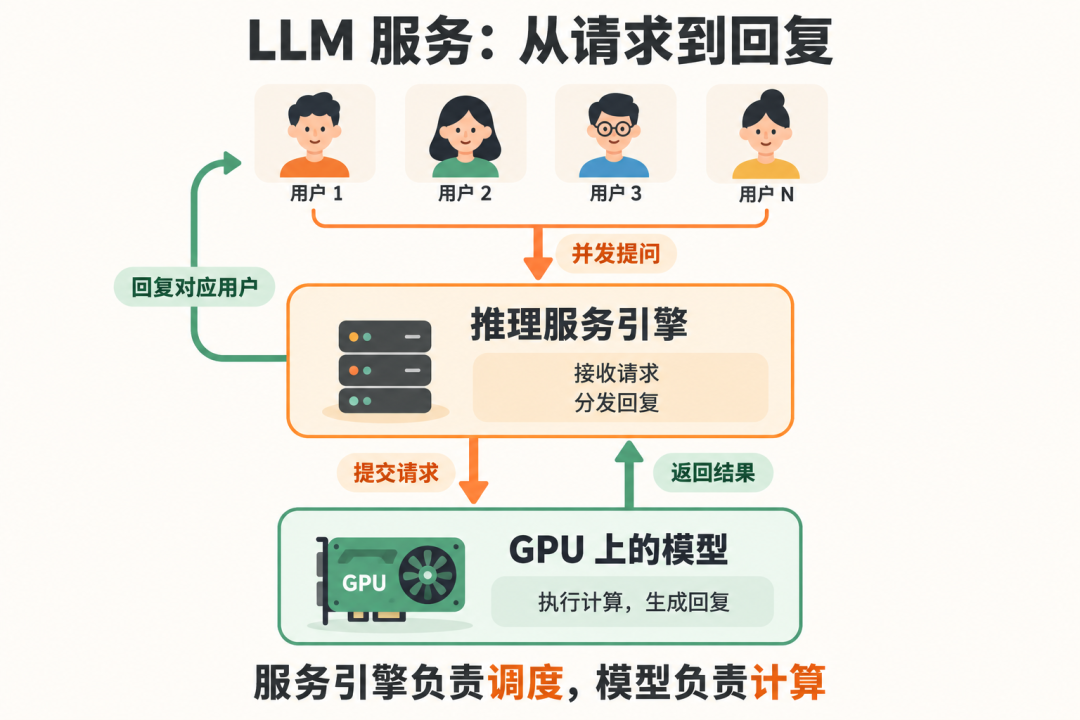
图中,许多用户同时发来问题。推理服务引擎位于中间,收集所有请求,将它们交给 GPU 上的模型处理,再把每条回复发给对应的用户。
这里有一点很重要:大语言模型运行在一种名为 GPU 的专用芯片上。GPU 是一种强大的处理器,擅长完成大语言模型所需的大量数学计算。但 GPU 价格昂贵,显存容量也有限。如果浪费显存,就只能服务更少的用户,成本也会随之上升。
因此,推理服务的目标是:在一张 GPU 上,尽可能快速地服务尽可能多的用户。记住这个目标,vLLM 正是为此而设计的。
02•快速回顾预填充、解码与 KV 缓存
要理解 vLLM,需要先了解大语言模型如何生成回答。
收到提示词后,模型并不会把文本当成完整的单词来阅读。它会先把文本切分为称作 token 的小片段。一个 token 是一小段文本,大致相当于一个单词或单词的一部分。这样,提示词就变成了一个 token 序列。
接下来,模型分两个阶段工作。
第一个阶段是预填充(prefill)。在写出回答之前,模型先读取完整提示词,处理其中的每个 token。简单说,预填充就是模型阅读并消化整段提示词的过程。
第二个阶段是解码(decode)。这时,模型开始逐个 token 生成回答:先生成一个 token,参考截至当前的全部内容,再生成下一个,持续进行,直到回答结束。
在这两个阶段中,模型都会为每个 token 计算一些内部数值,并将它们保存起来。这些数值存放在 KV 缓存(Key-Value cache,键值缓存)中。
可以把 KV 缓存理解得更直观一些:模型每读取或生成一个 token,都会为它写下一份小结,像一组“笔记”,记录这个 token 在前文语境中的信息。KV 缓存就是这些笔记的集合,每个 token 对应一组。
KV 缓存之所以重要,是因为在解码阶段,每生成一个新 token,模型都需要用到此前所有 token 的笔记。如果没有 KV 缓存,每生成一个新词,都得重新计算这些笔记,速度会非常慢。因此,模型把笔记计算并保存一次,之后反复使用。KV 缓存让长回答的生成变得更快。
需要记住的一点是:
回答越长,KV 缓存就越大。每增加一个 token,KV 缓存中就会增加一组笔记,而这些笔记都保存在 GPU 显存里。
这两个阶段,以及 KV 缓存逐渐增长的过程,可以用下图表示:
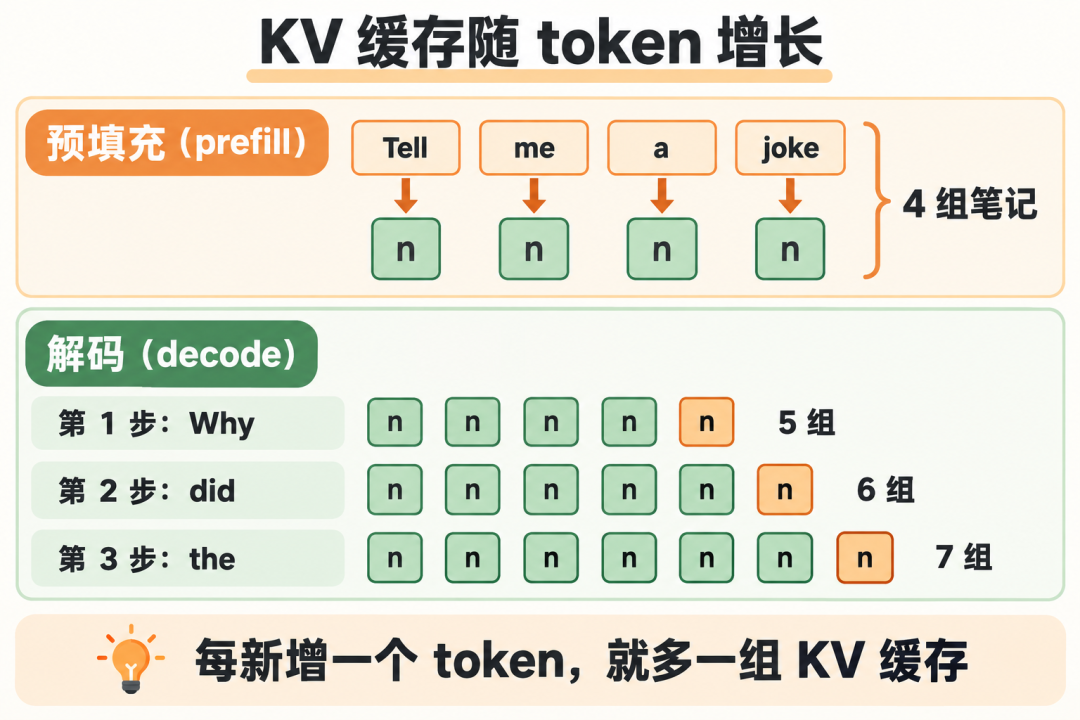
图中,预填充一次性为提示词中的每个 token 建立一组笔记。随后,解码逐个 token 生成回答,每增加一个 token,就向 KV 缓存添加一组笔记。因此,回答越长,KV 缓存在显存中占用的空间就越大。
有了这些基础,就可以来看真正的问题了。
03•问题所在:KV 缓存消耗大量显存
了解 KV 缓存是什么之后,再看看它会带来什么麻烦。
模型本身会占用很大一部分 GPU 显存,剩余显存则用于存放当前正在处理的所有请求的 KV 缓存。
因此,KV 缓存决定了能同时服务多少用户。可用于 KV 缓存的空闲显存越多,能一起运行的请求就越多。
简单说,每个正在处理的请求都有自己的 KV 缓存,而且缓存会随着回答变长而持续增长。服务许多用户时,它们的 KV 缓存会同时驻留在显存里,争用同一份有限空间。
所以,提供大语言模型服务时,真正的瓶颈是 KV 缓存占用的显存,而非数学计算速度。KV 缓存压缩技术可以缩小每份缓存,但无论压缩到多小,引擎仍然必须把它管理好。
这意味着,推理服务的挑战归根结底在于显存管理。KV 缓存管得好,就能服务更多用户;管得不好,就会浪费 GPU 资源,只能服务更少的用户。
接下来的问题是:常规的做法如何管理这些显存,又为什么效果不好?
04•常规的服务方式为什么浪费显存
一个简单、普通的推理服务引擎会怎样处理 KV 缓存,以及问题出在哪里。
通常做法看起来很稳妥,实际上却很浪费。请求到来时,引擎不知道回答会有多长。为保险起见,它会先预留一大块连续显存,大小足以容纳最长可能回答所需的缓存。
假设模型最多能生成 2,000 个 token。对于每个请求,普通引擎都会立即预留能存放 2,000 个 token 的 KV 缓存空间,即使模型还没有开始生成回答。
问题在于,大多数回答都很短。如果某个用户的回答只有 50 个 token,那么其余 1,950 个 token 对应的空间就只能闲置:虽然被预留了,却没有使用。为一个本不需要这么多空间的回答,占下了大量显存。
这里涉及两种浪费,都需要弄清楚。
第一种是过度预留(over-reservation):预留的显存远远超过请求实际使用的量。这些已预留却未使用的空间不能分配给其他请求,因此被浪费了。
第二种是碎片化(fragmentation):空闲显存被分割成许多零散的小块,无法有效使用。可以借助图示来理解。
常规做法如下图所示:
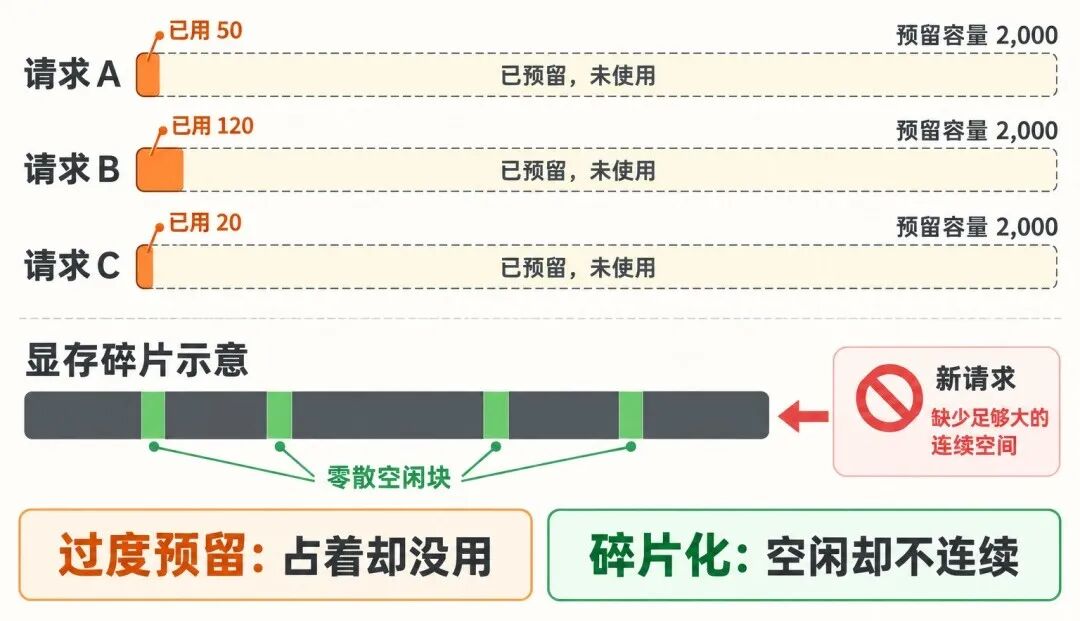
图中,每个请求都占据了一大块连续空间,却只用到了前面的一小部分,其余空间被浪费。各块之间剩余的空隙又太小、太分散,装不下一个新请求。因此,即使从总量上看还有许多空闲显存,也无法利用起来。这就是碎片化。
结果并不理想。GPU 的显存容量看起来很充裕,但由于空间被浪费或分散,一次只能服务少量用户。为强大的 GPU 付了钱,却只用到了其中一小部分资源。
这时,就轮到 vLLM 来解决问题了。
05•什么是 vLLM?
理解了问题,再来看看解决方案。
vLLM 是一个高吞吐的大语言模型推理服务引擎。它通过高效管理 KV 缓存占用的显存,尽可能让一张 GPU 服务更多请求。
简单说,vLLM 是一个善于管理资源的推理服务引擎,能够减少显存浪费,从而同时服务更多用户。
先解释一下“高吞吐”中的吞吐量(throughput):它指单位时间内完成的工作量。高吞吐量意味着每秒能够处理更多 token 和请求,这正是 vLLM 要尽量提高的指标。
vLLM 依靠两个相互配合的核心思路来解决这一问题:
- PagedAttention:把 KV 缓存组织成固定大小的小块,而不是一整块巨大空间,从而避免浪费显存。
- 连续批处理(continuous batching):每一步都移出已完成的请求,再加入新请求,让 GPU 持续处理任务。
接下来会分别详细介绍。先从 vLLM 的核心 PagedAttention 讲起。
06•核心思路:PagedAttention
一步步理解 vLLM 背后的核心思路。
PagedAttention 使用固定大小的小块来管理 KV 缓存,按需分配显存,而不是一开始就预留一大块空间。
简单说,vLLM 不会为每个请求一下子占下大量显存,而是将空间切成大小相等的小块,只有在请求确实需要更多空间时才分配。
这个思路借鉴了操作系统的内存管理方式。操作系统把内存划分为固定大小的小块,称作页(page)。程序需要更多内存时,操作系统就再分给它一页。这些页在物理内存中不必相邻,操作系统用一张小表记录每一页的位置。
vLLM 对 KV 缓存采用了同样的思路:把缓存空间划分为固定大小的块(block),每块容纳固定数量 token 的笔记,例如 16 个 token。请求需要存储更多 token 时,vLLM 就再分配一块。这些块不必相邻。vLLM 使用一张块表(block table),记录哪些块属于哪个请求,以及它们的顺序。
用一个例子走一遍这个过程。
第 1 步:一个请求到来,开始生成回答。vLLM 为它分配一个块,足以存放 16 个 token 的缓存。请求开始逐渐填满这个块。
第 2 步:回答超过 16 个 token,第一个块已经填满。vLLM 只需再分配一个空闲块,无论这个块位于显存中的哪里,都可以使用,不必紧挨着第一个块。
之后:回答继续增长,vLLM 就继续按需逐块分配。回答结束后,vLLM 一次性释放该请求的所有块,这些块随即就能分配给其他请求。
可以用下面这张简单的图来表示:
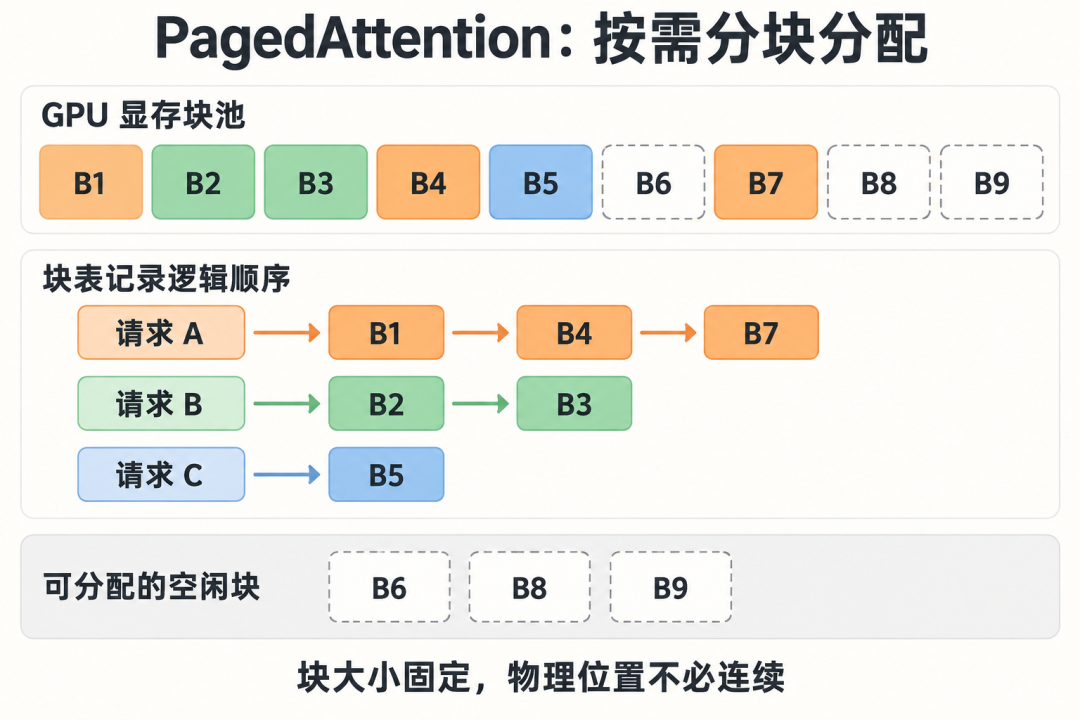
图中,显存是一池大小相等、可共同使用的块。每个请求只获得实际需要的块,这些块可以分散在池中的任意位置。块表就像一张小地图,把请求与属于它的块按正确顺序关联起来。请求完成后,它占用的块立即回到空闲池,供后续请求使用。
这样,问题就解决了。只有真正需要时才分配一个块,因此不会过度预留;每个块大小相同,任何空闲块都能分配给任意请求,所以几乎没有碎片化,显存浪费也降到了接近于零。
07•PagedAttention 如何共享显存
PagedAttention 还有一个很巧妙的好处:有了块之后,就能顺势实现共享。
KV 缓存由小块组成后,两个不同请求的块表可以指向显存中的同一个块,无需各自保存一份副本。也就是说,内容相同的部分可以共享同一份显存。
下面看两个共享能发挥很大作用的实际场景。
第一种是相同前缀。前缀就是一段内容的开头。假设许多用户的请求都以同一段很长的系统指令开头,例如:“你是一家汽车经销商的客服,请礼貌地为客户提供帮助。”这段开头对所有请求都一样。采用块结构后,vLLM 可以只保存一份共同前缀的 KV 缓存,再让每个请求指向这些相同的块。同一组笔记只需存储一次,由各请求共享,无需重复保存。
第二种是束搜索(beam search)。束搜索是一种文本生成方法:模型同时探索多个可能的回答,最后保留最好的一个。这些候选序列称为束(beam),它们开头相同,只在后续部分有所不同。采用块结构后,所有束都可以共享共同开头对应的块,只在真正分叉的地方使用各自独立的块。
共享过程如下图所示:
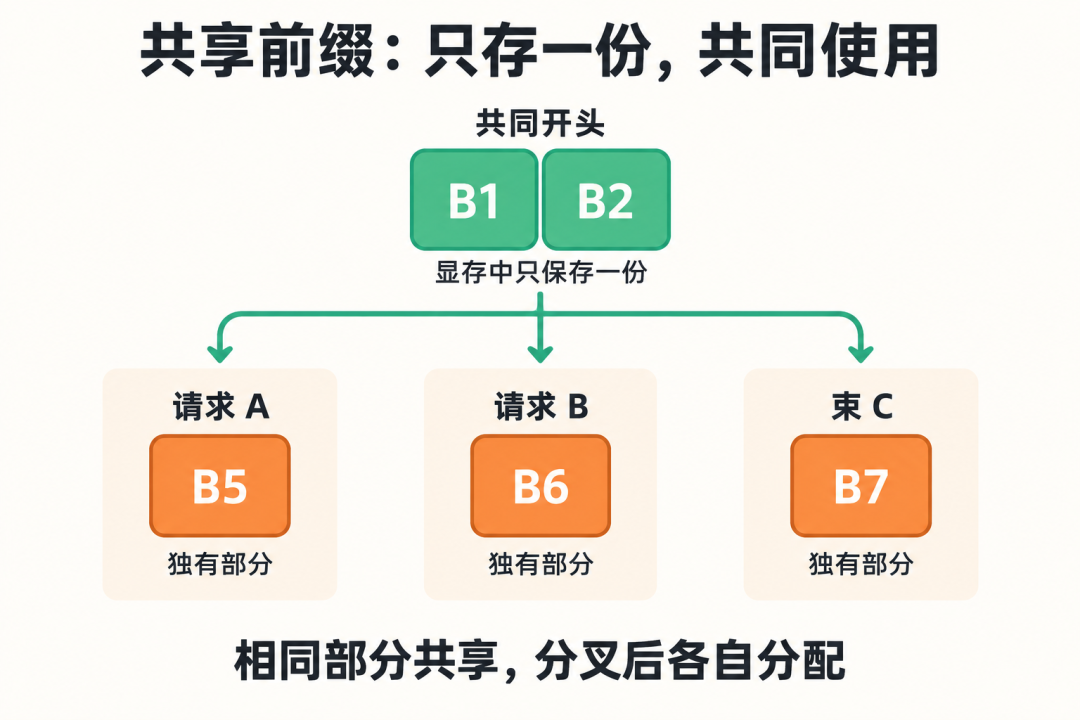
图中,B1 和 B2 存储相同的开头,在显存中只保留一份。三条不同路径都指向这两个共享块,只为各自特有的部分添加独立块。这样,就省去了把同一段开头存储三遍所需的额外显存。
PagedAttention 既减少了浪费,也让请求能够共享显存,使同一张 GPU 能容纳更多用户。
08•连续批处理
接下来介绍 vLLM 的第二个核心思路,它与 PagedAttention 相互配合。
先理解批处理(batching)。批处理就是把多个请求放在一起运行,而不是一次只处理一个。GPU 同时处理多个请求时效率高得多,因此,批处理能让 GPU 保持忙碌,提高吞吐量。
不过,朴素的批处理方式存在一个问题。
这种做法称为静态批处理(static batching):先收集一批请求,一起运行;只有等这一批中的所有请求都完成,才能开始下一批。
问题在于,不同请求生成的回答长度差异很大。一个用户的回答可能只有 20 个 token,另一个却有 800 个。在静态批处理中,短请求很早就完成了,却必须空等长请求结束,因为整批请求要一起进退。等待期间,已经完成的请求所占的 GPU 处理槽位不做任何工作,GPU 时间就这样被浪费了。
连续批处理正是为解决这个问题而来。
连续批处理在每一步都移出已经完成的请求,并加入正在等待的新请求,而不必等整批请求全部完成。
简单说,一个请求完成后,vLLM 就把它移出,并立即从等待队列中取一个新请求来接替。GPU 无需闲着等待。
别忘了,解码是逐个 token 生成回答的,因此会经历许多小步骤。每一步,vLLM 都会检查:有没有请求刚刚完成?如果有,就将它移出,再加入一个新请求。这样,批次中始终保持着正在处理的工作。
用图来对比两种方式:
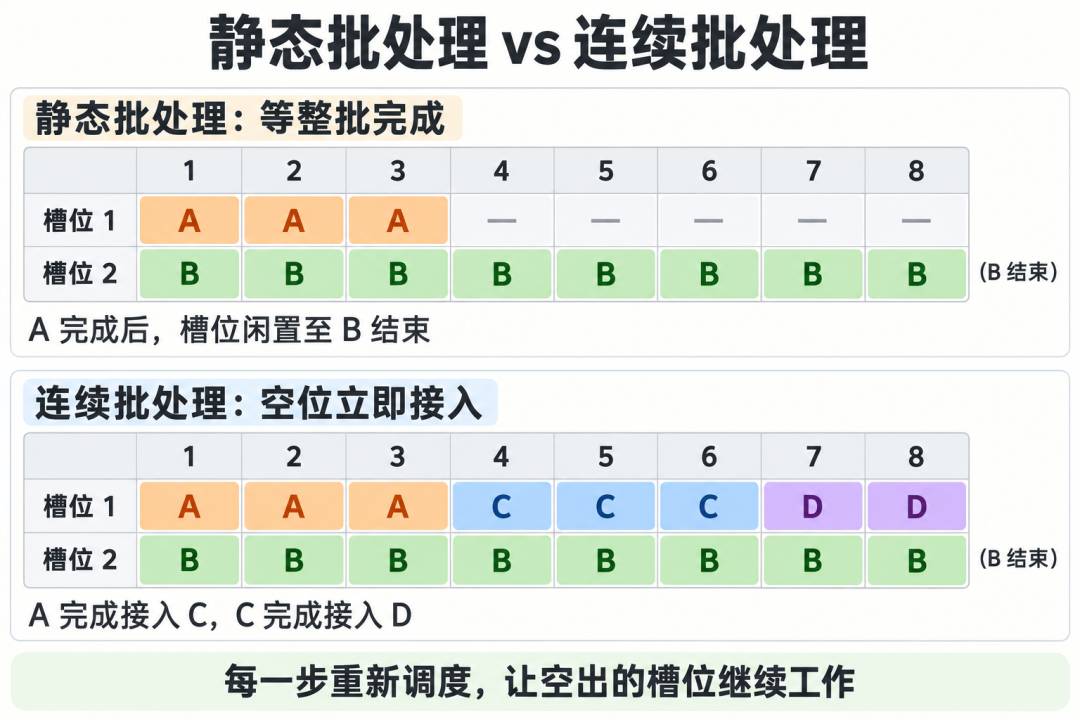
图中,静态批处理的请求 A 很早就完成了,但它的槽位一直闲置,直到较慢的请求 B 结束。连续批处理则会在 A 完成后立即让请求 C 接入;C 完成后,再让请求 D 接入。整个过程中,GPU 持续工作,槽位没有被浪费。
连续批处理与 PagedAttention 配合得很好。PagedAttention 及时释放已完成请求占用的块,连续批处理随即将释放的显存和空出的槽位用于等待中的新请求。两者共同提高显存和 GPU 计算资源的利用率。
vLLM 就是这样让 GPU 持续高效运转的。
09•兼容 OpenAI API 的服务端
接下来看看,实际使用 vLLM 时是怎样的。
vLLM 提供兼容 OpenAI API 的服务端。
它可以作为服务器运行,监听聊天请求,并返回模型的回复。
这一点很重要,因为大量工具和应用已经按照 OpenAI API 的方式编写。如果 vLLM 使用相同的接口协议,只需更改服务地址,就能让这些现有工具连接自己的 vLLM 服务器,无需重写代码。可以在自己的 GPU 上运行自己的模型,应用仍以原先调用 OpenAI 的方式与之通信。
因此,vLLM 在内部提供高吞吐的推理服务引擎,在外部提供熟悉、易用的 API。这让它很容易接入实际项目。
10•vLLM 的优势
把这些优势放在一起回顾一下,也就能理解为什么要使用 vLLM。
- 吞吐量显著提高。PagedAttention 减少显存浪费,连续批处理减少 GPU 时间浪费。因此,与朴素引擎相比,vLLM 每秒可以处理更多 token,服务更多用户。
- GPU 利用率更高。利用率指 GPU 资源实际被使用的程度。vLLM 让显存和计算资源都接近充分利用,使昂贵的硬件发挥更大价值。
- 每个请求的成本更低。一张 GPU 可以服务更多用户,分摊到每个用户的成本就会明显下降。
- 容易接入。兼容 OpenAI API,意味着只需很少的修改,就能把 vLLM 接入现有应用。
简单说,vLLM 让模型在同一张 GPU 上,以更快的速度、更低的成本服务更多用户,而不改变回答的质量。模型仍然生成相同的回复,vLLM 只是减少了显存和时间的浪费。
这就是 vLLM 的巧妙之处。
11•vLLM 的实际应用
最后,看看 vLLM 在实际系统中用在哪里。
vLLM 是最受欢迎的开源推理服务引擎之一,许多希望在自己的 GPU 上运行开放大语言模型的公司都在使用它。只要需要让一个模型同时服务大量用户,vLLM 就是一个很有竞争力的选择。
vLLM 并不是唯一的推理服务引擎。SGLang 采用了不同的前缀共享方式:通过基数树(radix tree)精确匹配共享文本,而不是使用固定大小的块。在 NVIDIA 硬件上,还有 NVIDIA 自己的引擎 TensorRT-LLM,它深入到底层,使用针对各代 GPU 调优的计算内核。
vLLM 尤其适合以下两类系统。
第一类是高流量聊天应用。许多用户同时聊天时,连续批处理让 GPU 的每个处理槽位都有工作可做,PagedAttention 则让更多用户的 KV 缓存装进同一份显存。因此,用更少的 GPU 就能服务大量用户。
第二类是智能体(Agent)系统。智能体是一种逐步完成任务的 AI 程序,往往需要调用工具,并经过多轮交互才能完成工作。智能体每一步都会发送相同的大段指令,因此,PagedAttention 对相同前缀的共享能够节省大量显存;连续批处理则让大量短步骤接续运行,减少空闲等待。
因此,只要需要以高效、低成本的方式让大语言模型服务大量用户,vLLM 都能提供很大帮助。
这就是 vLLM 的工作原理:像操作系统管理内存一样管理 KV 缓存,通过 PagedAttention 按需分配固定大小的小块,并在请求之间共享;通过连续批处理,在每一步调入、调出请求,让 GPU 持续工作;再把这些能力封装在熟悉的、兼容 OpenAI 的 API 后面,从而在同样的硬件上获得更高吞吐量和更好的 GPU 利用率。
12•常见问题
vLLM 会改变模型回答的质量吗?
不会。vLLM 不改变回答质量,模型仍然生成相同的回复。它只是减少 GPU 显存和计算时间的浪费,让模型在同一张 GPU 上以更快的速度、更低的成本服务更多用户。
数学计算速度是大语言模型推理服务的主要瓶颈吗?
不是。真正的瓶颈是 KV 缓存占用的显存,而非数学计算速度。每个请求都有自己的 KV 缓存,且会随回答增长;所有缓存又共享有限的显存。因此,显存管理得好不好,决定了能服务多少用户。
从 OpenAI API 切换到 vLLM,需要重写应用吗?
不需要。vLLM 提供兼容 OpenAI API 的服务端,只需更改服务地址,就能让现有工具连接自己的 vLLM 服务器,无需重写代码。应用调用自有模型的方式,与原来调用 OpenAI 的方式相同。
vLLM 是唯一的大语言模型推理服务引擎吗?
不是。vLLM 是最受欢迎的开源推理服务引擎之一,但还有其他选择。SGLang 使用不同的前缀共享方式,通过基数树精确匹配共享文本,而不是使用固定大小的块。在 NVIDIA 硬件上,还可以选择 NVIDIA 自己的引擎 TensorRT-LLM。
为什么 vLLM 适合智能体系统?
智能体在每一步都会发送相同的大段指令。PagedAttention 对相同前缀的共享,使共同的开头只需存储一次,节省了大量显存。同时,连续批处理让智能体的大量短步骤接续运行,减少 GPU 的空闲时间。
本文转载自微信公众号「AI灰鲸」,仅供学习交流使用。
觉得内容不错?我要