
万字长文!企业级Agent调用治理和MCP网关实战
本文来源: 徐小夕(公众号:徐小夕)
原文链接: https://mp.weixin.qq.com/s/Eg33URH4HhXcP5FkGp1Tsw
发布时间: 2026-09-14 08:10
作者: 徐小夕 发布时间: 2026-09-14 08:10
往期精彩:
攻克 Web 文档难题:JitWord 如何实现业界顶尖的 Word 高精度解析与渲染
对比实测:为什么 JitWord 是目前最适配商用的 Web Word 编辑器?
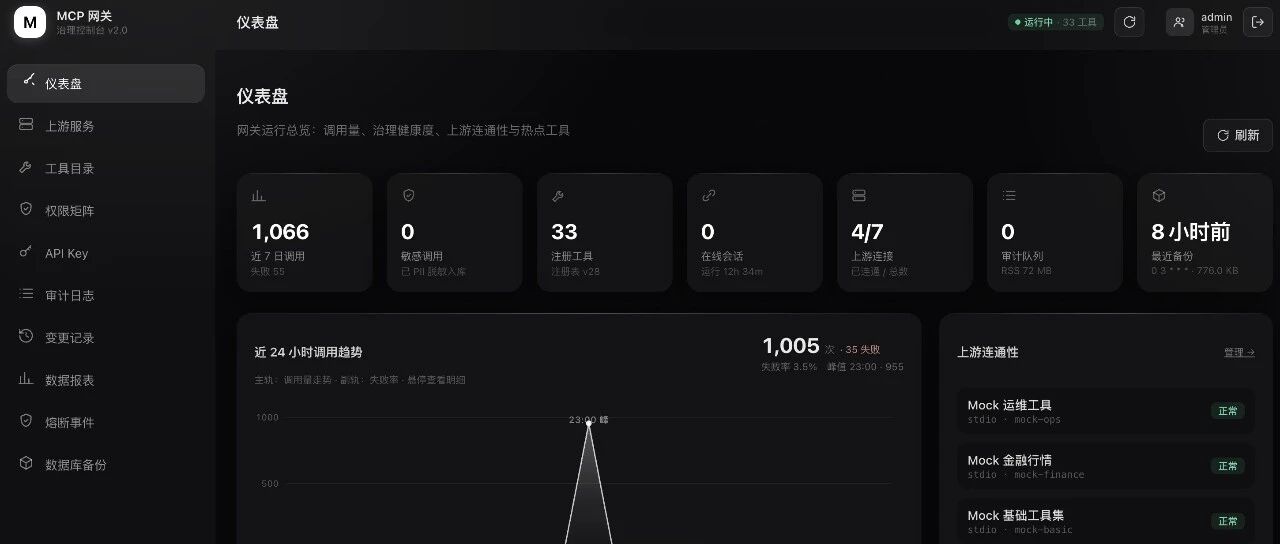
很高兴又和大家分享我们对 AI 技术的深度思考和实践。今天分享的是 MCP 网关设计实践:
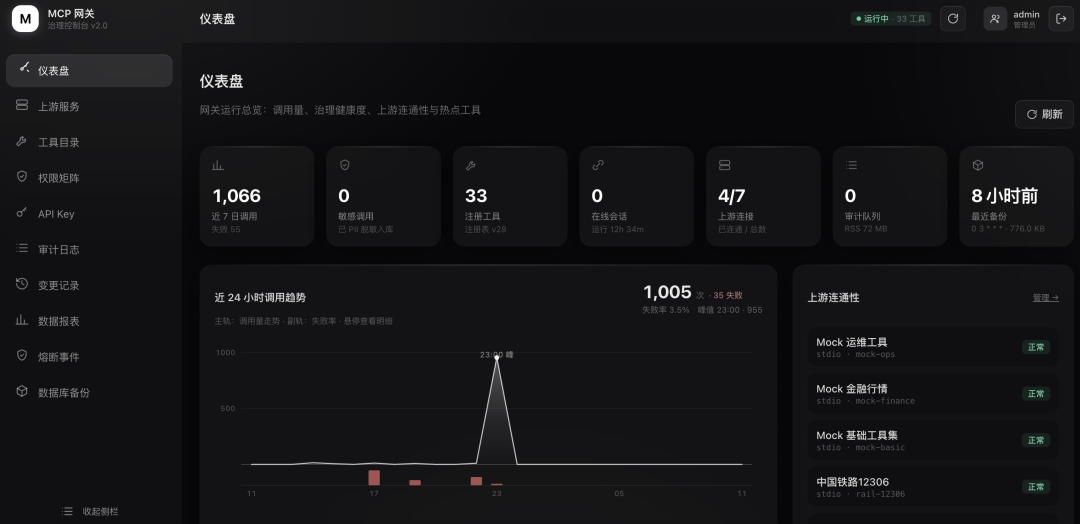
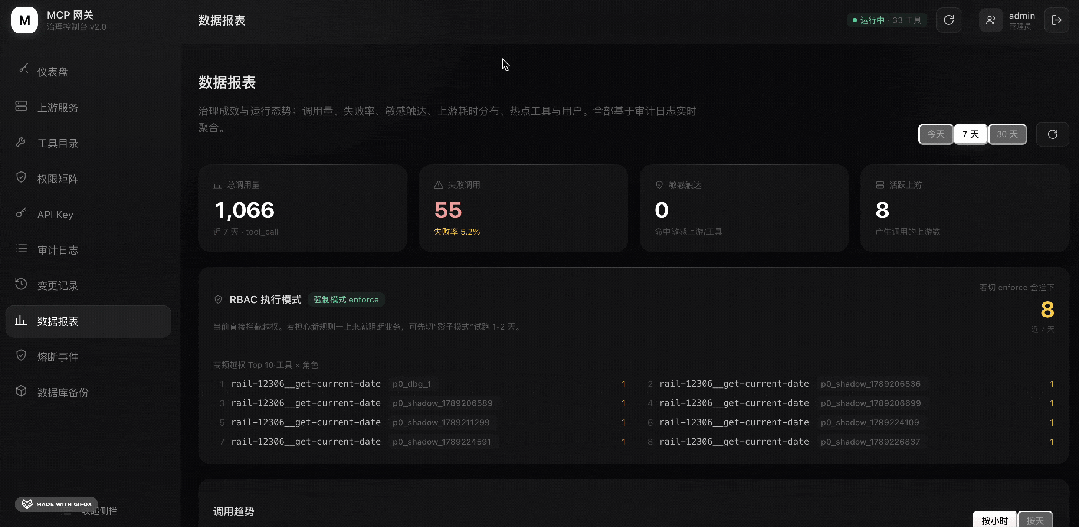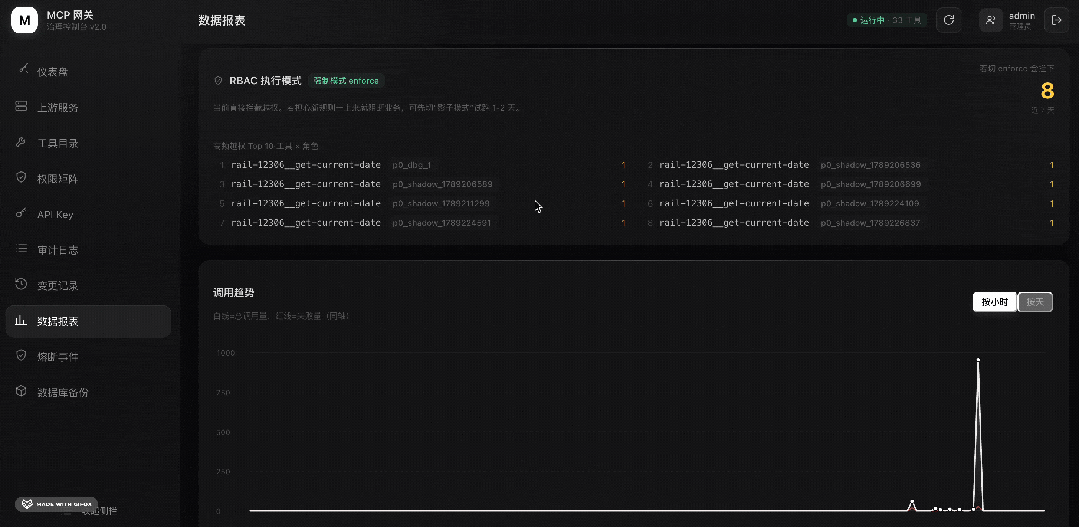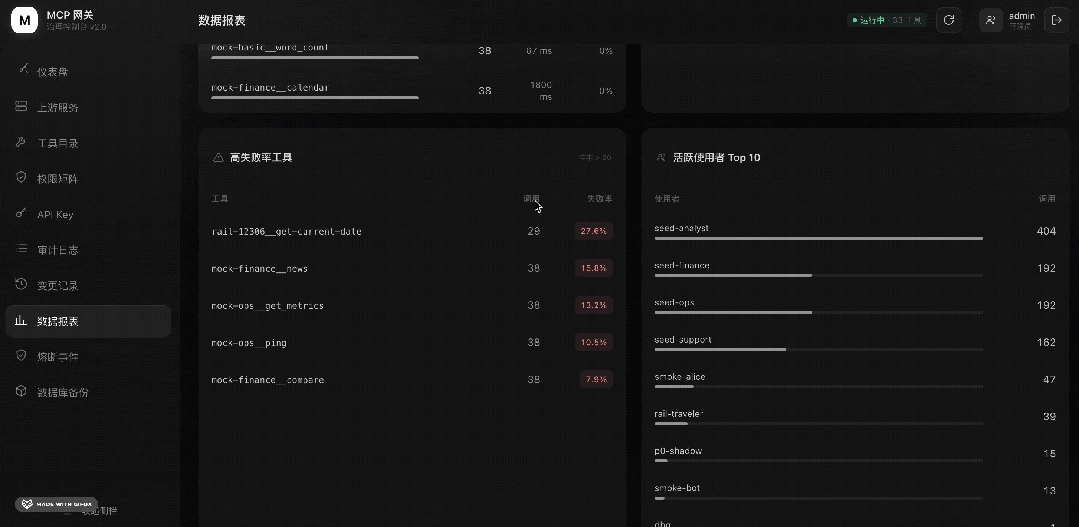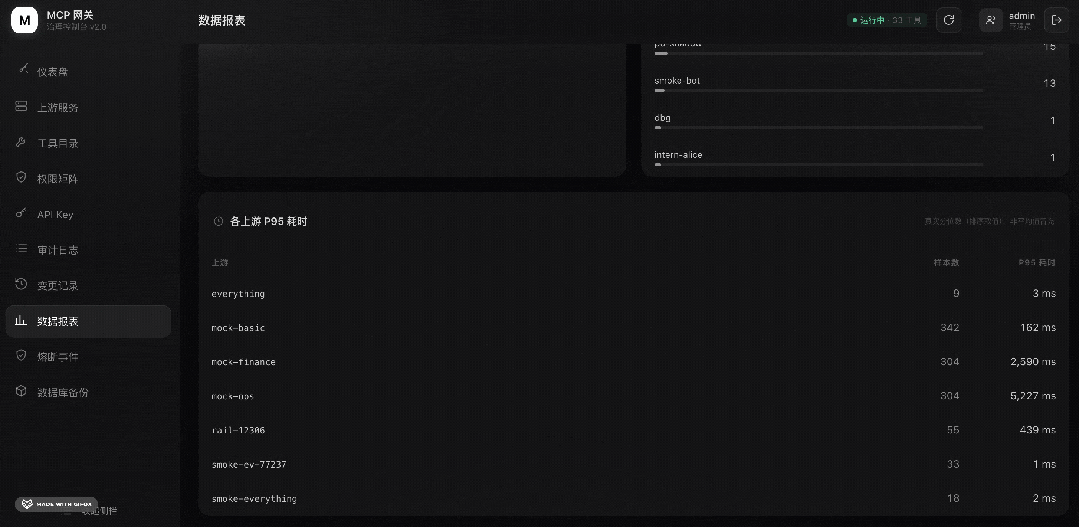
文章略长,建议收藏再看。
项目源码我会分享到 AI全栈学习手册 的Plus实战项目中,供大家参考学习。
文档学习地址:https://aibook.mvtable.com/mcp-docs
一、为什么要做MCP网关项目
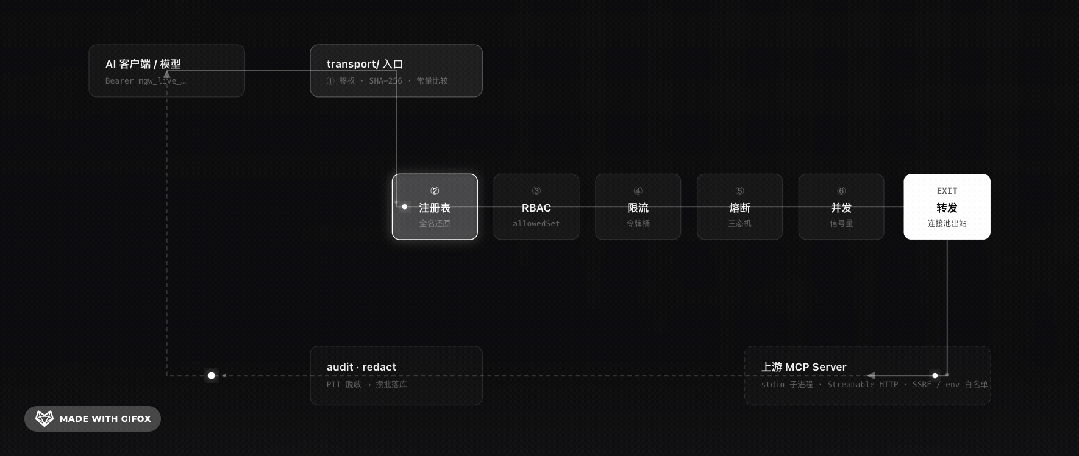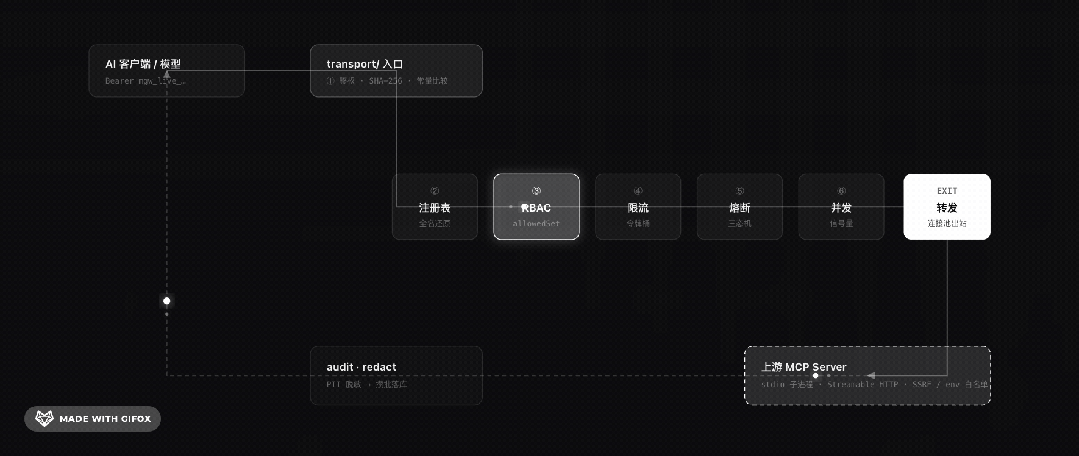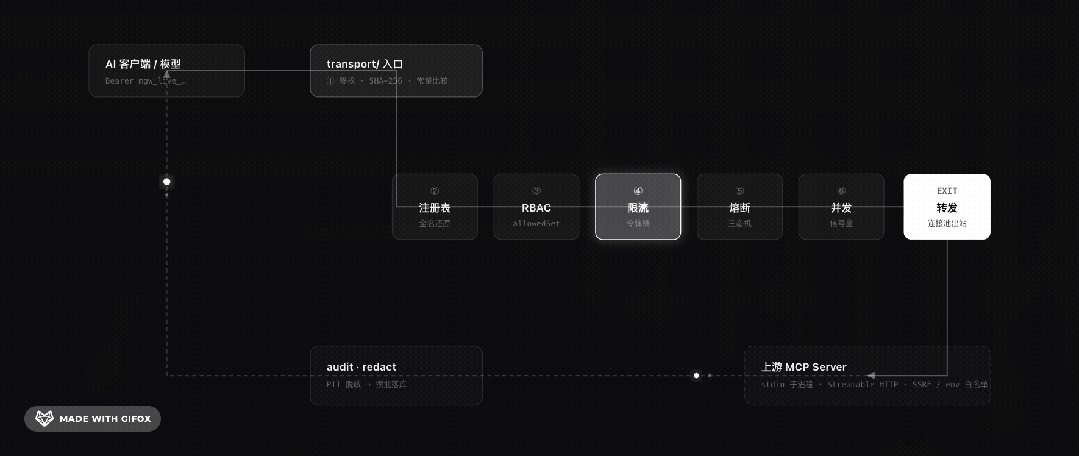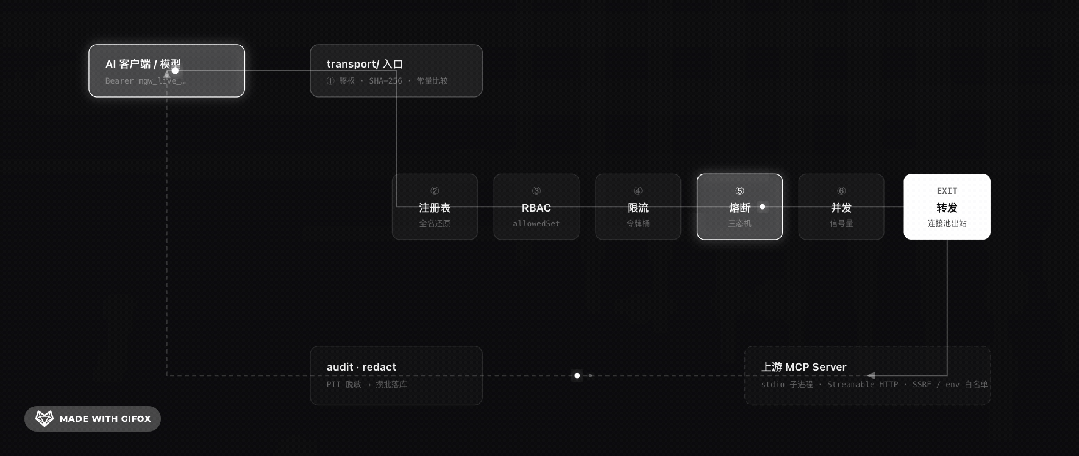
事情起因很简单。公司里越来越多的 Agent、Copilot、自研应用,都想要调用内部工具:查订单、发工单、读知识库、跑数据。一开始大家各接各的,谁家 AI 应用要什么工具,就自己去对接一个 MCP Server。
按这个模式跑了一段时间后,问题全冒出来了。工具散落一地没有统一入口,权限粗放到「能连上就能全调」,调用没有审计根本说不清谁动了数据,最要命的是各种密钥明文散落在各个 .env 里,维护成本极高。
还有一件事让我非常难受:某个上游服务阻塞了,几十个 Agent 的请求全堵在那儿排队,直接把整条链路拖垮。一个上游掉链子,全公司跟着罢工。
下面我总结了如下几个痛点,供大家参考一下:
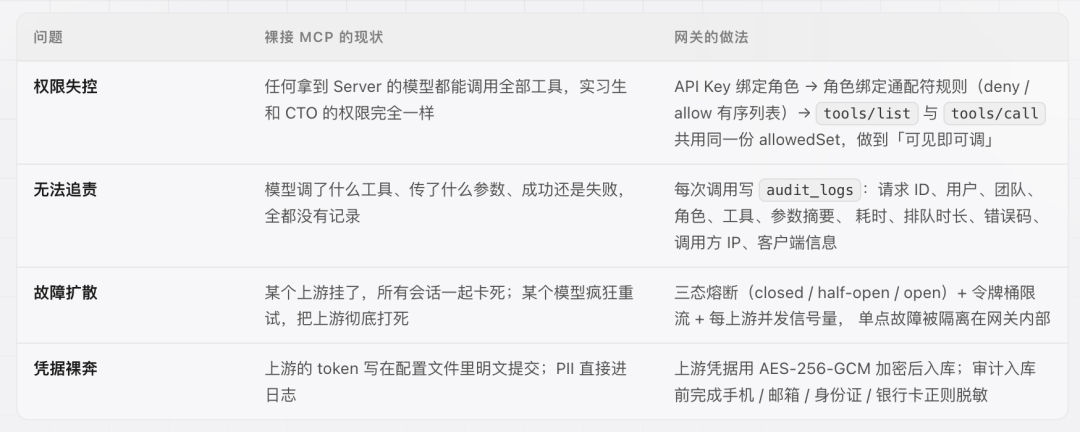
我们意识到:这些鉴权、限流、审计、脱敏的活儿,不该散在每个业务方手里,重复造轮子,而应该沉到一个统一中间层来管理。
于是有了这个 MCP 网关 项目。
二、它到底是什么
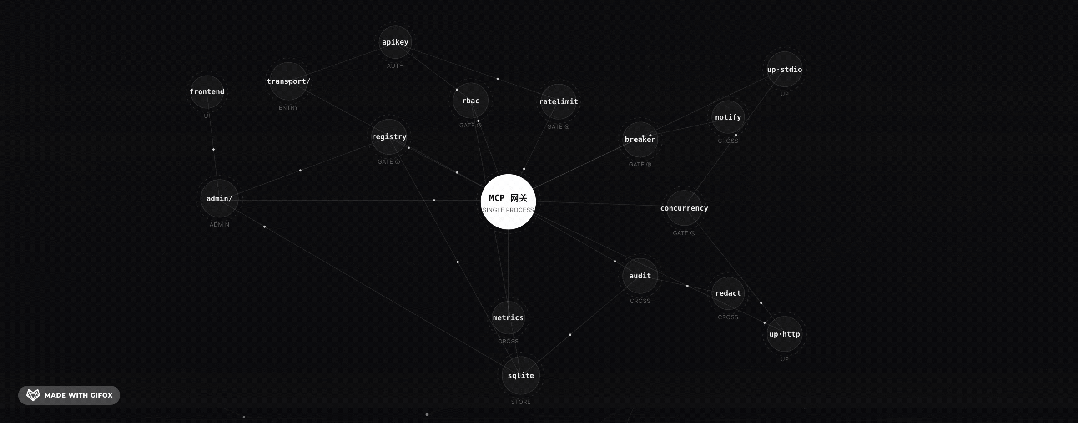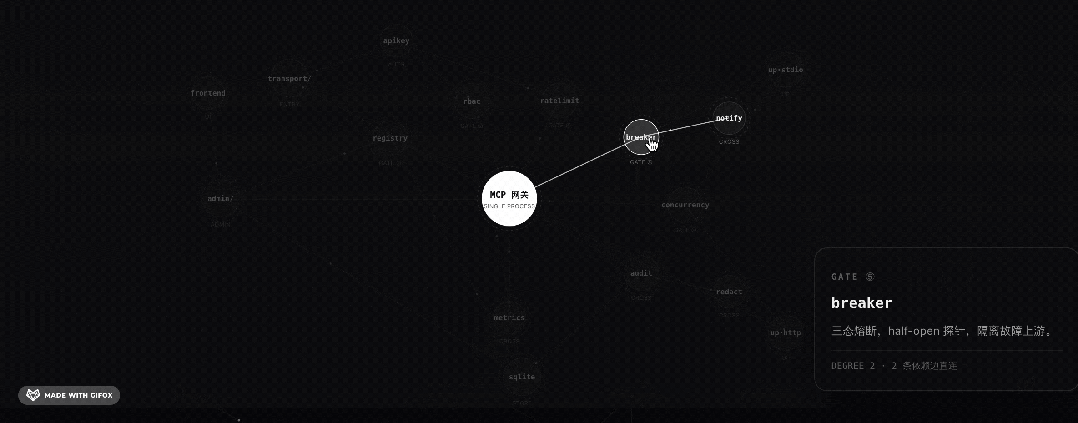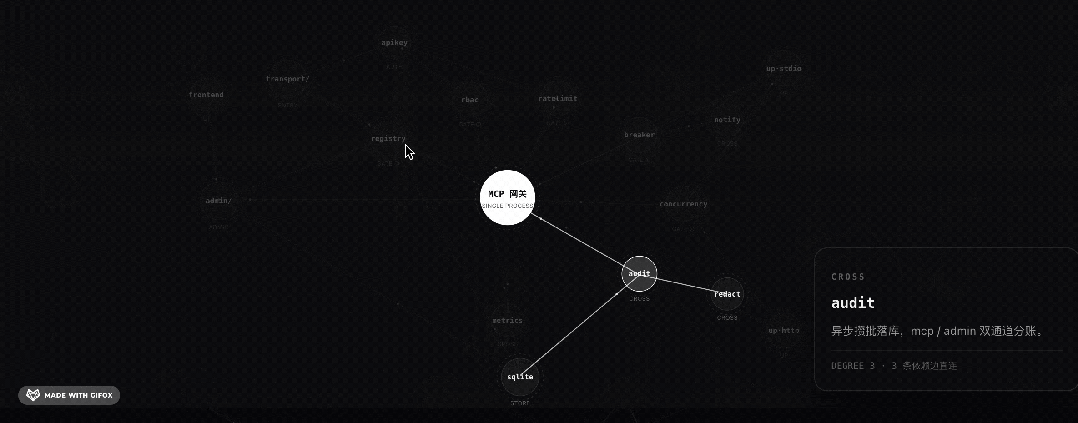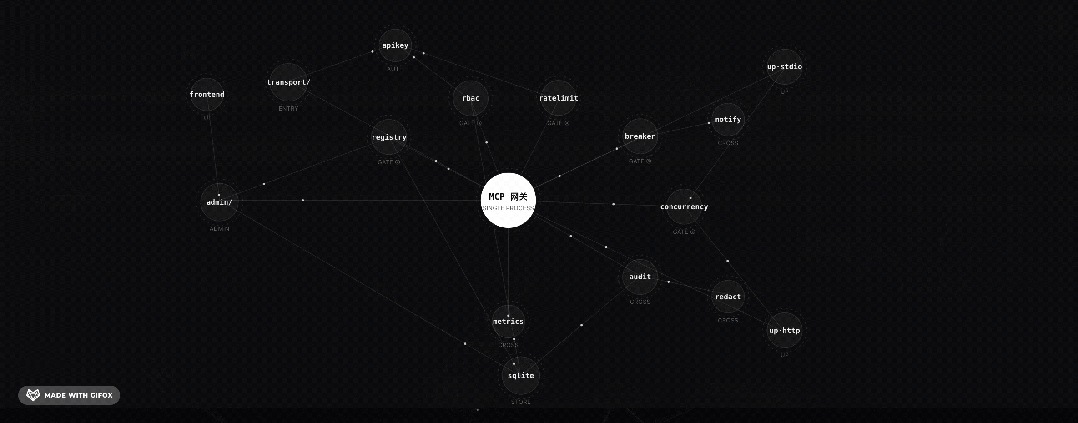
一句话:对上是唯一一个 MCP Server,对下以 MCP Client 身份聚合 N 个上游,中间把鉴权、RBAC、限流、熔断、并发、审计、脱敏、凭据加密一次性做成治理闭环。
零门槛就能跑起来:存储用的是单文件 SQLite(WAL 模式),不依赖任何外部数据库;一条 ./start.sh 就把前后端、依赖、初始化全带起来。
我们的核心定位和技术栈如下:
定位:企业级MCP 工具治理网关
后端栈:NestJS + TypeORM + SQLite + MCP SDK
前端栈:Vue3 + Vite + UnoCSS(黑白毛玻璃主题)
关键数字:11 张表 · 8 道治理闸 · 10 大管理页 · 5 档冒烟脚本
三、功能亮点与细节分享
先和大家聊聊这个MCP网关项目的核心亮点,给大家做一个直观的认知:
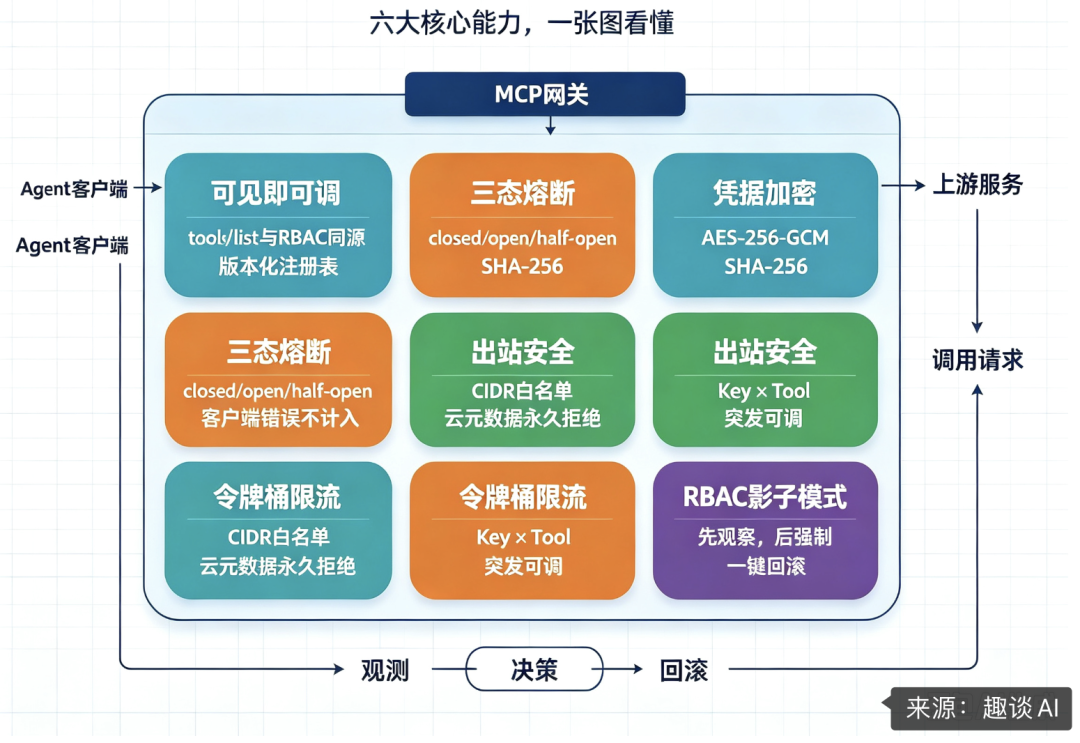
下面详细给大家介绍一下。
1. 可见即可调,杜绝「列得出调不动」
很多网关的坑是:tools/list 给模型列了一堆工具,结果模型一点就 403。我们把 tools/list 的返回集和 RBAC 的放行集做成同源——模型眼睛里看到的,就一定是它手够得着的。
这背后是注册表版本化:工具集或规则一变就 bump 版本号,RBAC 结果按版本缓存,还会向在线会话广播 tools/list_changed,模型立刻刷新认知。
2. 三态熔断:一个上游打嗝,不牵连全局
熔断器有 closed / open / half-open 三态:窗口内连续失败超阈值就 open 快速失败,冷却后放一个探针去 half-open,探活成功回血、失败立刻再熔断。
我觉得最有价值的设计是:客户端错误(传错参、无权)不计入熔断。否则随便谁来传个错参数,就能把一个好端端的上游熔掉——这在多租户环境里是致命的。
3. 凭据 AES-256-GCM 加密,明文只出现一次
上游的密钥、API Key 一律用 AES-256-GCM 加密入库;网关自己签发的 MCP Key 只存 SHA-256 哈希,明文在签发响应里只打印一次,关窗就再也捞不回来。
解密失败时我们绝不静默返回乱码,而是显式抛错——宁可让运维第一时间感知主密钥不匹配,也不让脏数据悄悄流到线上。
4. SSRF 出站白名单,云元数据地址永久拒绝
上游 URL 是管理员手填的,本质上等于开了个内网探测口。我们把出站锁进 CIDR 白名单,默认拒绝一切,并且对 169.254.0.0/16 这类云元数据地址无论怎么配都永久拒绝。
再加上禁跟随重定向、fetch 层对解析后的 IP 二次校验,把 DNS rebinding 这条后门也堵上。
5. Key × Tool 令牌桶,贴合 Agent「一阵一阵」的节奏
限流我们选令牌桶而不是固定窗口,因为 Agent 的调用天然是突发式的——允许短时 burst,又卡住平均速率。粒度做到 一把 Key × 一个工具,还支持工具级 QPM 覆写。
一个容易漏的点:桶数量是 Key 乘工具,几百乘几百轻松上到几十万,所以我们做了每 60 秒一次的陈旧桶回收。
6. RBAC 影子模式:新规则先「看着拦」,再「真拦」
上线一套新权限规则最怕一刀切把业务打停。我们做了 observe 影子模式:越权调用照样放行,只是写一条 rbac_would_forbid 审计。报表里能直接看到「如果切成强制,会拦下多少次真实调用」。
配套的还有一键回滚(基于变更前快照)、影响面量化预览(受影响 Key 数、近 7 天命中量)。规则改崩了不慌,随时可回退。
文档中有详细的介绍,大家可以参考一下:
文档地址:https://aibook.mvtable.com/mcp-docs
四、整体架构
先看全景。整个网关有两条物理隔离的通道:对模型的 /mcp(用 API Key),对管理员的 /admin/api(用独立 Admin Token)。两条通道不共享代码路径,从根上降低越权面。
下面是我设计的架构图,供大家参考:
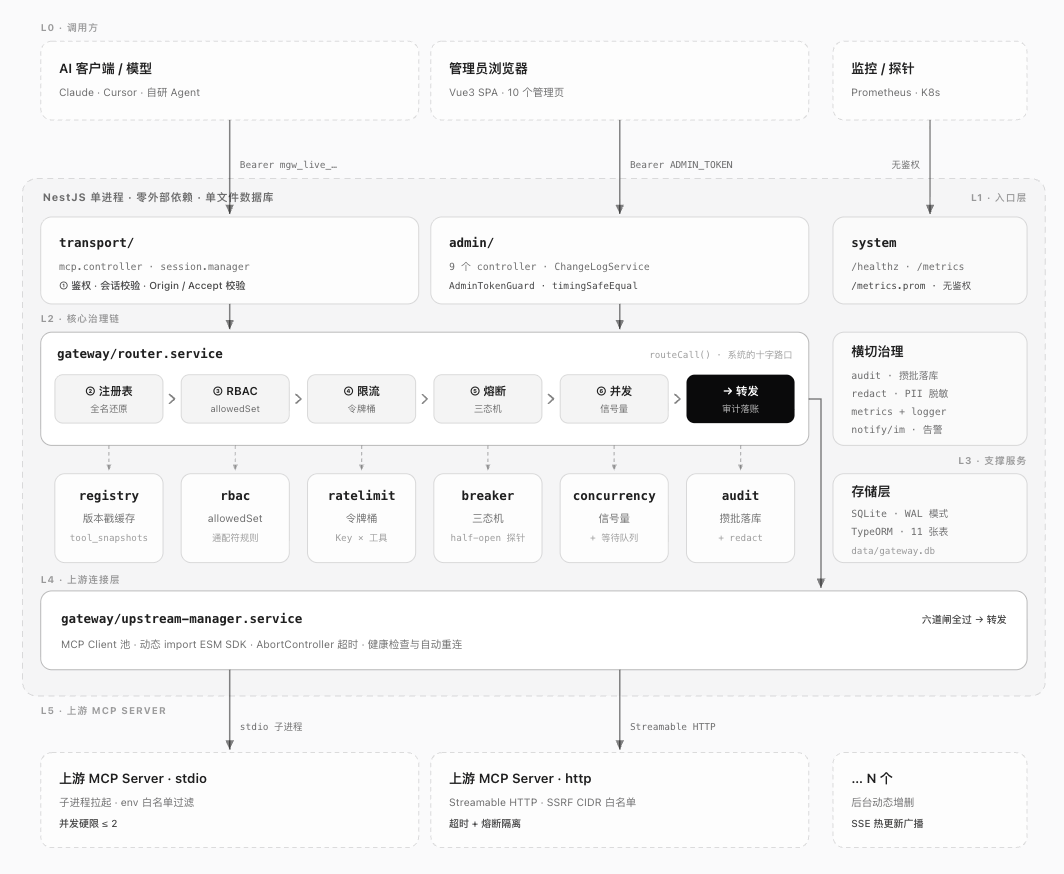
下面分享几个关键选型,都是我们经过实践之后的技术复盘。
1. 存储为什么用单文件 SQLite(WAL)?
因为我们要的是「开箱即用、零外部依赖」——不用先拉起一套 MySQL/Redis 就能部署,运维成本压到最低。
2. 为什么用 NestJS + TypeORM?
治理链本质是一串可组合的服务,NestJS 的依赖注入让注册表、上游、RBAC、限流、熔断、并发、审计这些 Service 像积木一样拼进 router,顺序显式可控。
MCP SDK 是 ESM,后端是 CommonJS,我们靠动态 import 桥接,stdio 与 HTTP 两种 transport 都能兼容使用。
整套选型我们总结了一份详细的清单,大家如果在做类似的项目,也可以参考一下:
| 层级 | 关键选型 | 负责什么 | 为什么选它 |
|---|---|---|---|
| 运行时 | Node.js ≥ 20.18.1 | 原生模块载体 | better-sqlite3 原生编译稳定 |
| 后端框架 | NestJS | 模块化 + 依赖注入 | 治理链各闸像积木可编排 |
| 数据层 | TypeORM + better-sqlite3(WAL) | 11 张表 · 单文件存储 | 零外部依赖,单机即用 |
| 协议层 | @modelcontextprotocol/sdk | 对外 Server / 对下 Client | 动态 import 桥接 CJS ↔ ESM |
| 参数校验 | zod | 管理端入参强校验 | 把非法请求挡在治理链外 |
| 前端 | Vue3 + Vite + Pinia + UnoCSS | 黑白毛玻璃管理后台 | 主题沉淀为 shortcuts,构建快 |
| 安全 | AES-256-GCM · SHA-256 · SSRF 白名单 | 凭据加密 · Key 哈希 · 出站收敛 | 纵深防御,默认不信任 |
| 可观测 | prom-client · node-cron · IM Webhook | 指标 · 自动备份 · 告警 | 上线即可运维 |
📌 表 1|技术栈全景(分层选型设计)
五、一次调用走过的 8 步
一个 tools/call 从进网关到回结果,会依次穿过 8 道闸。顺序是刻意锁死、不能调换的:权限在限流前(没资格不该耗令牌),限流在熔断前(被限流不该污染熔断统计),熔断在取并发槽前(熔断态不该排队)。
趣谈AI① 注册表查找工具是否存在 / 启用② RBAC可见即可调③ 令牌桶限流Key × Tool④ 三态熔断open 快速失败⑤ 并发信号量stdio 强制串行⑥ 超时转发callTool(timeout)⑦ PII 脱敏参数摘要去敏⑧ 审计攒批异步落库不阻塞
📌 图 2|主流程:一次 tools/call 依次穿过 8 道治理闸
再单独看敏感数据怎么流转。核心原则就一句:明文能少出现就少出现,能不落盘就不落盘。
趣谈AIMCP Key 明文SHA-256只存哈希 · 明文仅签发时出现一次上游凭据 / headersAES-256-GCM密文入库 iv + tag + ciphertext调用参数 argsPII 脱敏审计留痕 · 可导出 CSV
📌 图 3|敏感数据流转:三类明文的收敛路径
六、实现原理:四道最能说明问题的大关
这一节不贴代码,只讲背后的设计思路。我们挑四个最能体现取舍的地方,说清楚「为什么这么做、好处是什么」。
原理一 · 治理链的「顺序」本身就是产品
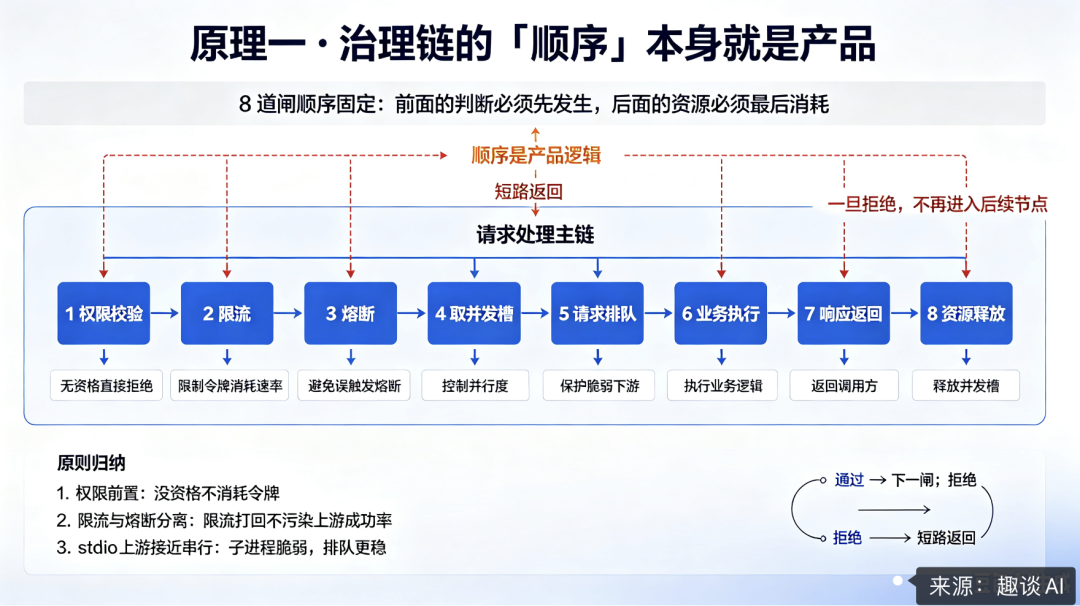
一次调用要依次穿过 8 道闸,而这个顺序是刻意锁死、不能调换的。为什么权限要排在限流前面?因为没资格的请求,压根不该消耗令牌。为什么限流要排在熔断前面?因为被限流打回的不该污染上游成功率、误触发熔断。为什么熔断要排在取并发槽前面?因为一个已经不健康的服务,不该再让请求白白排队。
每道闸一旦拒绝就立刻短路返回,绝不浪费后面的资源。还有个反直觉的细节:stdio 类型上游的并发被压到接近串行——子进程本就脆弱,让它老老实实排队反而最稳。
原理二 · 权限:可见即可调,还能开影子模式
RBAC 最容易翻车的地方,是「列表里看得到、调用却被拒」这种不一致。我们的做法是让 tools/list 与权限放行集同源:同一个 Key 能看到的工具一定调得动;判定结果按注册表版本缓存,命中直接放行,未命中才看模式开关。
两种模式:enforce(默认)越权即拒并记审计;observe(影子模式)照常放行、但把「本应拒绝」记成一笔影子审计——用真实流量先验证策略会不会误伤,再一键切回强制。
趣谈AI
tools/call · 工具全名命中 allowedSet?与 tools/list 同源 · 按版本缓存命中未命中放行 → 限流 / 熔断(可见即可调)rbac.mode 判定强制影子enforce:直接拒绝FORBIDDEN + 审计observe:仍放行写 would_forbid 影子审计
📌 图 4|权限决策:命中即放行,未命中看 enforce / observe
原理三 · 熔断要「分清是谁的错」
熔断器用 closed / open / half-open 三态,按滑动窗口累计失败数,超阈值就快速失败;冷却一段时间后,只放一个「独占探针」去试探上游活没活过来,成功就回血、失败立刻再熔断。
最关键的一条思路是:客户端自己的错(传错参数、没权限)绝不计入熔断。否则任何调用方只要反复传错参数,就能把一个好端端的上游「熔」掉——很多现成熔断库没做这层区分,在我们这种多方共用网关里,这是不可妥协的安全底线。
趣谈AI
closed 正常失败计数累积open 熔断秒拒 fast-failhalf-open 半开独占 1 个探针窗口内失败 ≥ 阈值冷却到期探针成功·回血探针失败·再熔★ 客户端错误(传错参 / 无权限)不计数、不迁移,不计入上游成功率
📌 图 5|熔断三态状态机:closed / open / half-open
原理四 · 凭据「明文零留存」
网关签发的每把 Key,只在签发那一刻以明文出现一次,系统里只留哈希——哪怕数据库被整库拖走,也捞不出任何可用的 Key。
上游的密钥和请求头则整体加密存储,用的加密模式自带「防篡改校验」,密文只要被动过一个比特,解密就直接报错,绝不吐脏数据。更狠的一层是:网关刻意不把自己的运行环境透传给上游子进程,防止某个第三方上游顺走了主密钥。加密思路的尽头,是默认谁都不信任。
文档中有详细的介绍,大家可以参考一下:
文档地址:https://aibook.mvtable.com/mcp-docs
七、能用在哪,带来什么价值
• 多 Agent 统一收口:给不同团队 / 不同 Agent 各发一把 Key,一个入口管住所有被授权的上游工具。
• 敏感内网工具安全开放:加完审计 + 脱敏 + 限流,才把内部工具接给大模型,敢开也管得住。
• 多上游聚合与故障隔离:HTTP、stdio 混合上游统一命名空间 upstream__tool,一个挂掉不拖累别人。
• 合规留痕:谁、何时、用哪把 Key、调了哪个工具、参数摘要、耗时、是否触敏,逐条可查可导出。
• 分级授权:内置 intern / support / admin 三角色示范,deny 前置、到期时间、一键轮换。
写在最后
这个项目最让我们有成就感的,不是功能多,而是那 8 道闸的顺序和「客户端错误不计入熔断」这类设计取舍——都是被真实场景教育出来的。它的价值也很直接:把散落在各业务方的鉴权、限流、审计、脱敏、加密,下沉成一层公共能力,让每个团队不必重复造轮子,也让「Agent 接内部工具」这件高危的事,第一次变得可管、可查、可回退。
如果大家也在为「Agent 到底该怎么安全地接内部工具」头疼,希望这套治理闭环能给你一点参考。把混乱关进闸门里,把自由留给模型,这就是我们做 MCP 网关的初衷。
想获取学习源码?欢迎订阅我的AI全栈学习手册:
AI小册
https://aibook.mvtable.com
如果大家对AI知识库感兴趣,也欢迎加入我们一起把AI知识库打磨的更好:
同时大家也可以关注下方公众号获取更多AI协同办公解决方案:
先暂时聊这么多,后续会持续分享AI创业开源笔记,欢迎留言交流 ~
本文转载自微信公众号「徐小夕」,仅供学习交流使用。
觉得内容不错?我要