
AMD 395本地部署Qwen3.8-Flash-Next实测,端侧AGI时代也要来了
本文来源: 技术不求人(公众号:技术不求人)
原文链接: https://mp.weixin.qq.com/s/7yYuWFB71G2c4OAz2UG6EQ
发布时间: 2026-09-14 17:46
作者: 技术不求人 发布时间: 2026-09-14 17:46
过去一年,关于 AGI 的讨论,几乎都发生在云端。GPT-6 Astra 发布之后,"通用人工智能"这四个字,第一次从发布会 PPT 里,走到了真实产品里。
最近Qwen发布了Qwen3.8-Flash-Next模型,也有人说是Qwen4的预览版,我也在一台AMD 锐龙 AI Max+ 395 小主机上,完整跑通了千问最新的 Qwen3.8-Flash-Next:上下文 256K 拉满、多模态识图、写代码做游戏,一气呵成。
测完之后,我的结论是:云端 AGI 时代如果是 GPT-6 Astra 带来的,那么端侧 AGI 时代,很可能就是千问 3.8 引领的。
这篇文章,我用完整的实测数据,来论证这个判断。
01 Qwen3.8-Flash-Next:一个被"做小"的旗舰
先说结论:这不是一个小钢炮,这是一个被刻意"做小"的旗舰。
Qwen3.8-Flash-Next 是一个多模态 MoE 模型,总参数量 180B,但每次推理只激活 6B。你可以把它理解成一个 180 人的专家团队,但每次只叫醒 6 个最相关的人干活——能力是 180B 的能力,速度和功耗是 6B 的水平。
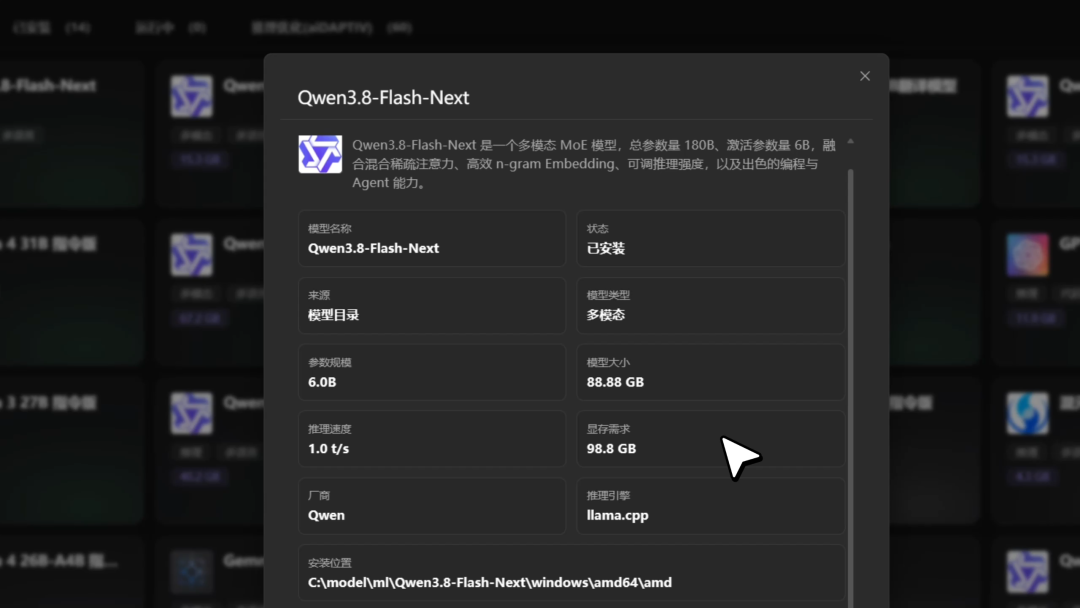
支撑它的,是三项关键技术:
混合稀疏注意力
长上下文不吃力,256K 的"金鱼缸"装得下,也算得动。
高效 n-gram Embedding
预填阶段可以"抄近道",读长文档、大图片时首字延迟更低。
可调推理强度
简单问题快答,复杂问题深思,快慢自己选。
再加上原生 256K 上下文、原生多模态(图表、公式、文档都能读)和出色的编程与 Agent 能力,这个模型的定位非常清晰:不只在云端跑分,更要能塞进你的电脑里,真正干活。
不过,94.50 GB 的模型体积、98.8 GB 的显存需求,也把一个问题摆在了桌面上:普通电脑,根本装不下它。
02 测试硬件:AMD 395,128GB 统一内存
这次用的测试设备,是一台搭载 AMD 锐龙 AI Max+ 395(代号 Strix Halo)的 AI 迷你主机。
先看硬指标:
| CPU | 16 核 Zen 5 / 32 线程,最高 5.1 GHz |
|---|---|
| 显卡 | Radeon 8060S,40 组计算单元(RDNA 3.5) |
| NPU | XDNA 2,最高 50 TOPS |
| 内存 | 128GB LPDDR5X-8000 统一内存,256-bit 位宽,约 256GB/s 带宽 |
这套平台真正的杀手锏,是最后那一行:统一内存(UMA)。
传统电脑上,CPU 和显卡各管各的内存,消费级显卡的显存天花板也就 16~24GB,连 70B 模型的 4-bit 量化版本都塞不下。而统一内存架构下,CPU 和 GPU 共享同一块超大内存池,最高可以把 96GB 直接划给 GPU 当显存用。
这就是 180B 总参 MoE 模型能够在一台"没有独显"的机器上跑起来的根本原因。98.8GB 的显存需求,在传统显卡面前是绝路,在 128GB 统一内存面前,只是一个"分配多少"的问题。
03 Herdsman 牧马人本地推理引擎:把部署门槛打到零
硬件解决了"装不装得下",下一个问题是"跑不跑得起来"。
传统本地部署的流程,劝退过无数人:配 Python 环境、装推理框架、跟 CUDA/ROCm 驱动搏斗、选量化格式、手敲启动命令、再调一堆参数……每一步都可能是几个小时的黑洞。
这次测试我全程用的是 Herdsman 牧马人本地推理引擎,它把整个流程压缩成了三步:
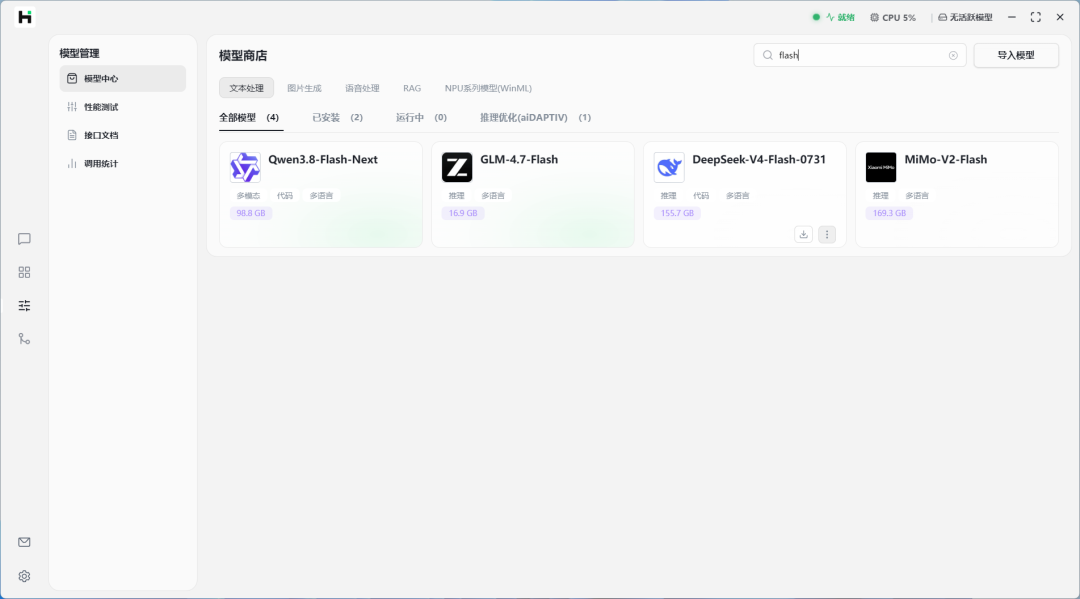
第一步,模型市场一键下载。模型中心提供海量模型,Qwen3.8-Flash-Next 一键部署安装。
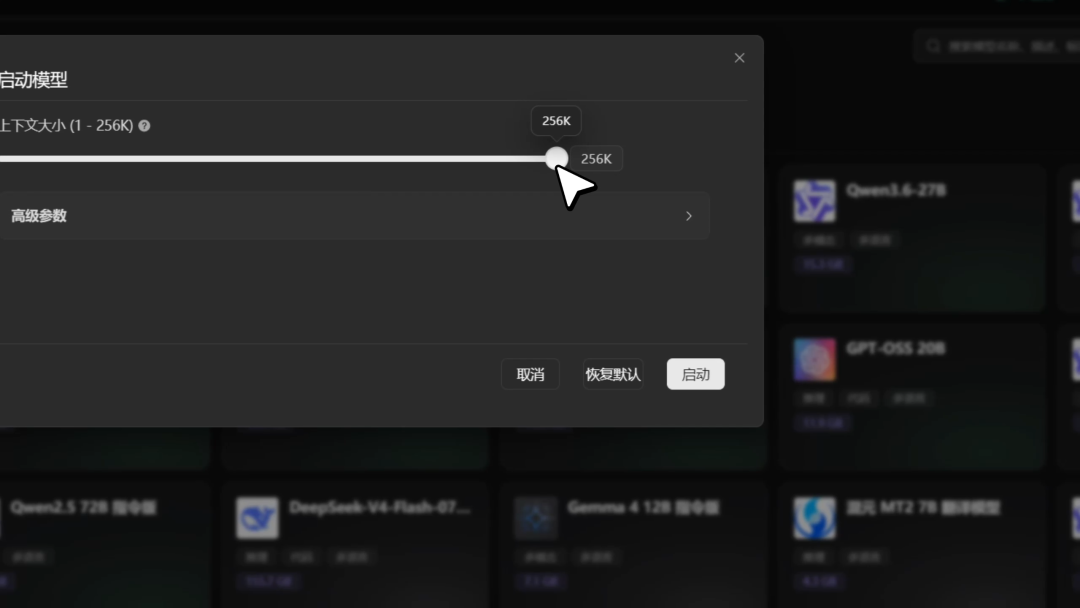
第二步,一键启动。自动适配硬件、自动选好后端(llama.cpp)、上下文大小拉个滑块就行——我把上下文直接拉到 256K 满格。
第三步,直接用。内置对话工作台开箱即用,同时对外提供 OpenAI 兼容 API,本地模型可以无缝接入各种 Agent 工具。
全程没有命令行,没有环境配置,纯小白也能在几分钟内完成部署,并把本地模型用到实际工作场景里——这一点,文章后面会专门演示。
一个值得单独说的细节:这次跑的是 AD 量化版本
我实际加载的不是全量模型,而是 Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64 量化版本。AD(aiDAPTIV)架构有一个独特优势:模型权重可以一部分驻留内存、一部分放在 SSD 上。
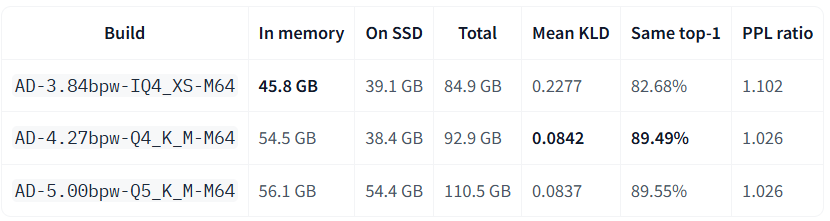
实测这个版本:54.5GB 权重驻留内存,38.4GB 放在 SSD,合计承载 92.9GB 的完整模型。启动模型的时候,打开任务管理器盯住 AI SSD,能明显看到 SSD 在持续高速读写——权重正是从 SSD 侧实时调度的。
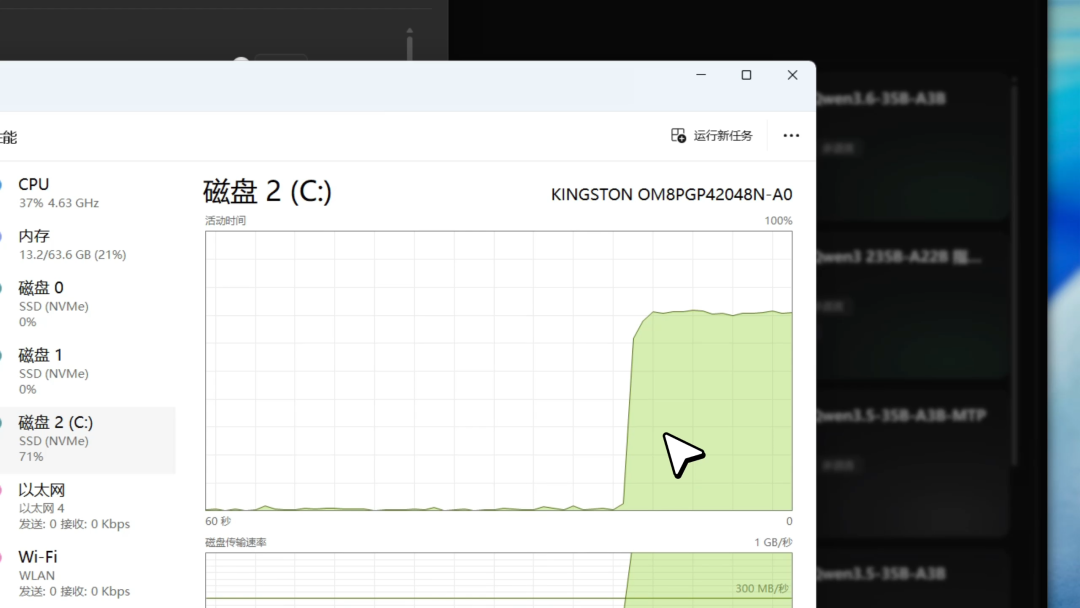
这里也跟各位提个醒:玩这种"权重上 SSD"的部署方式,SSD 尽量选 AI SSD。因为 AI SSD 里有专门划出来的 AI Cache 区域,高频的模型权重读写都发生在这块专用区域里,不会影响 SSD 的正常使用寿命。
更关键的是,精度几乎没有损失:这个量化版本与全精度输出相比,Mean KLD 仅 0.0842,top-1 重合度 89.49%,困惑度比值 1.026——大幅降低内存占用的同时,保住了几乎完整的模型能力。
04 实测:256K 上下文拉满,对话 + 识图双测
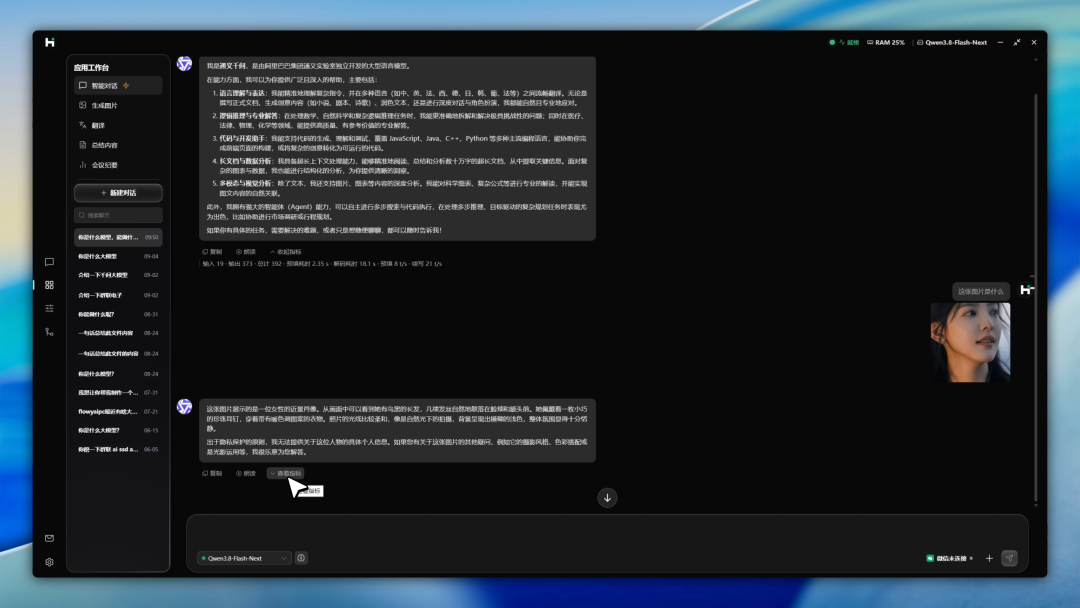
环境就绪,开始实测。第一轮,纯文本对话;第二轮,多模态图片识别。每一轮我都在结束后展开指标栏,把数据完整记录下来。
测试一:长回答对话测试
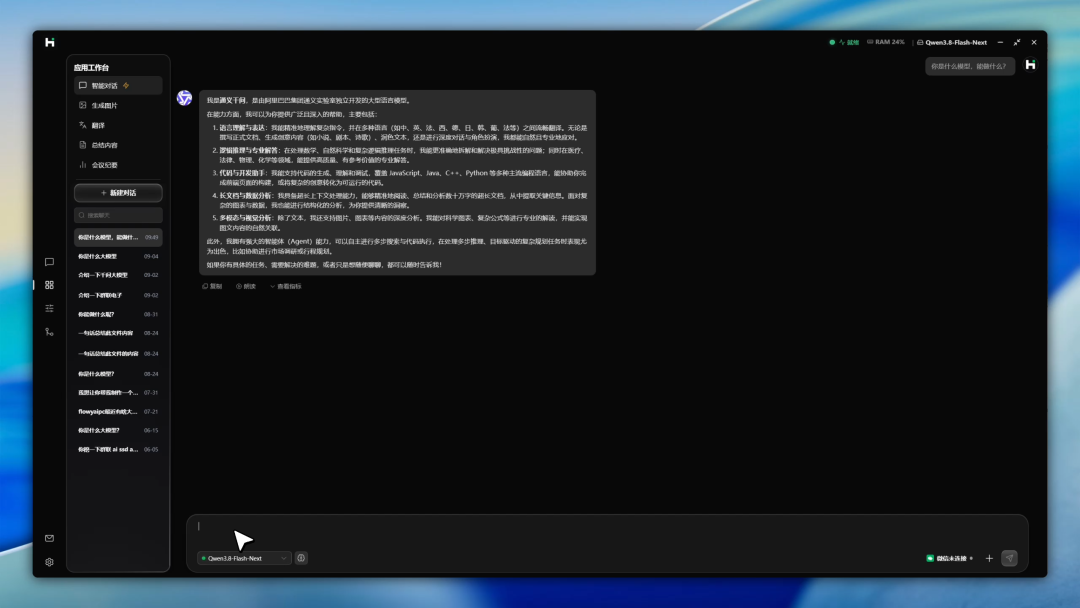
让模型做一次自我介绍并展开详细能力说明,考察长文本连续生成能力。
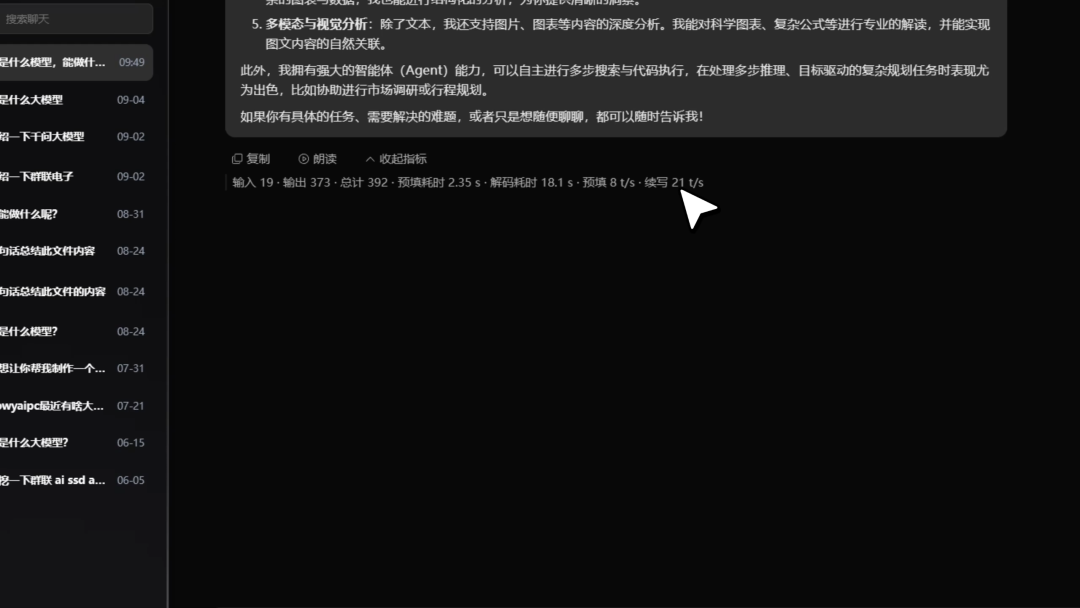
| 输入 | 19 tok |
|---|---|
| 输出 / 总计 | 373 tok / 392 tok |
| 预填耗时 / 速度 | 2.35 s / 8 t/s |
| 解码耗时 / 续写速度 | 18.1 s / 21 t/s |
怎么读这组数据?三个关键指标:
预填(读题):把你的输入一次性并行算完、建立缓存的过程,决定"等多久看到第一个字"。2.35 秒的开销对短输入来说几乎可以忽略。
解码(吐字):模型逐字生成回答,是整个体验的核心。21 t/s,已经超过了人眼舒适阅读速度(约 10~15 字/秒)——也就是说,模型"写"得比你"读"还快。
预填 8 t/s 不用在意:只有 19 个输入 token,耗时里全是固定启动开销,短输入下这个数字没有参考意义。
第二轮,上强度:扔一张人物照片过去,考察多模态识图。
测试二:多模态图片识别
上传一张近景人像照片,要求模型完整描述画面内容、光线与氛围。
| 输入(图片+文字) | 800 tok |
|---|---|
| 输出 / 总计 | 111 tok / 911 tok |
| 缓存命中 | 391 tok |
| 预填耗时 / 速度 | 12.2 s / 34 t/s |
| 解码耗时 / 续写速度 | 5.0 s / 20 t/s |
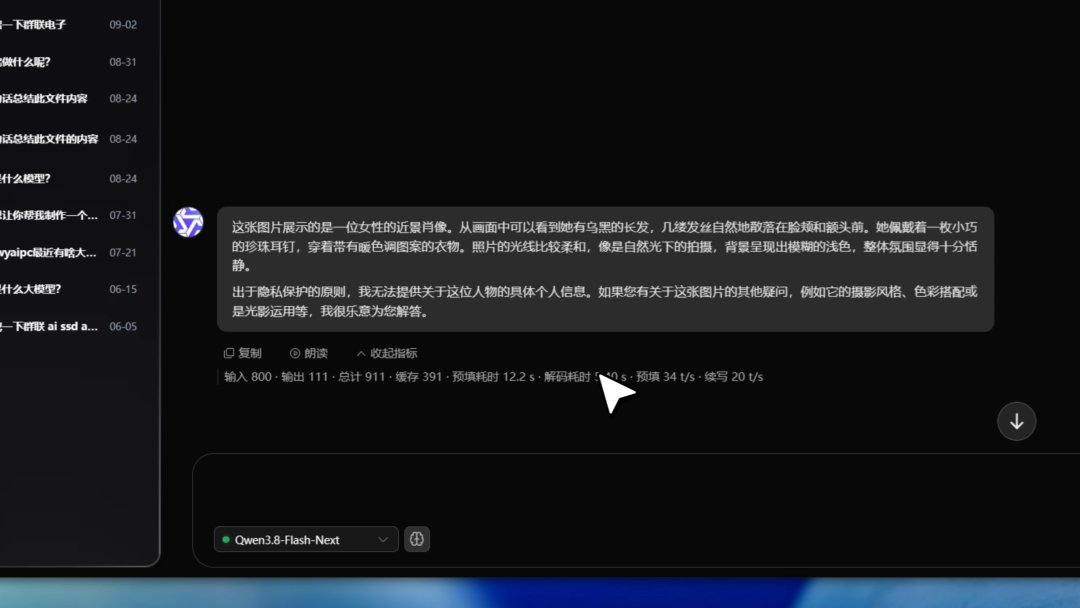
这组数据里藏着三个细节:
一,缓存机制在真实工作。输入 800 个 token 里,391 个命中了 KV 缓存(系统提示词和会话历史不用重算),实际重算约 409 个,409 ÷ 12.2 s ≈ 34 t/s,和显示的预填速度严丝合缝。多轮对话会越聊越快,这是本地部署的隐藏优势。
二,12.2 秒预填里含视觉编码。图片要先经过视觉模型转成 token,这部分是纯算力开销,所以识图场景的首字等待明显比纯文本长——这也是端侧多模态目前的主要瓶颈点。
三,续写速度纹丝不动。输入从 19 涨到 800,解码速度依然是 20 t/s,说明长上下文对生成速度几乎没有拖累——混合稀疏注意力不是白设计的。
总结一下:256K 上下文 + 多模态全开,续写稳定 20~21 t/s(有时候能稳定24t/s)——这个成绩,放在端侧是旗舰级的。
05 接入 WorkBuddy:12 分钟写一个桌球游戏
性能的好坏只能说明设备配置好,本地模型的终极价值,是把它接进真实的工作流。
Herdsman牧马人本地推理引擎 的"网关连接"页面提供了 Agent 一键配置:OpenClaw、Claude Code、Codex、CodeBuddy、WorkBuddy……主流 Agent 工具全在列表里,选中 WorkBuddy 点一下"一键配置",本地模型的 API 地址和密钥自动写入,全程不到一分钟。
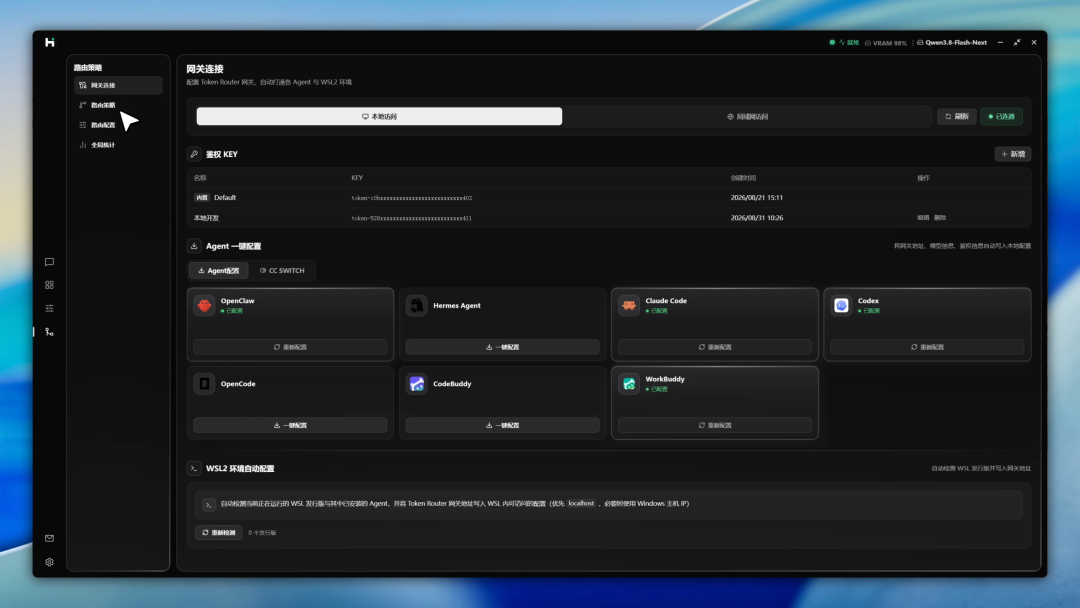
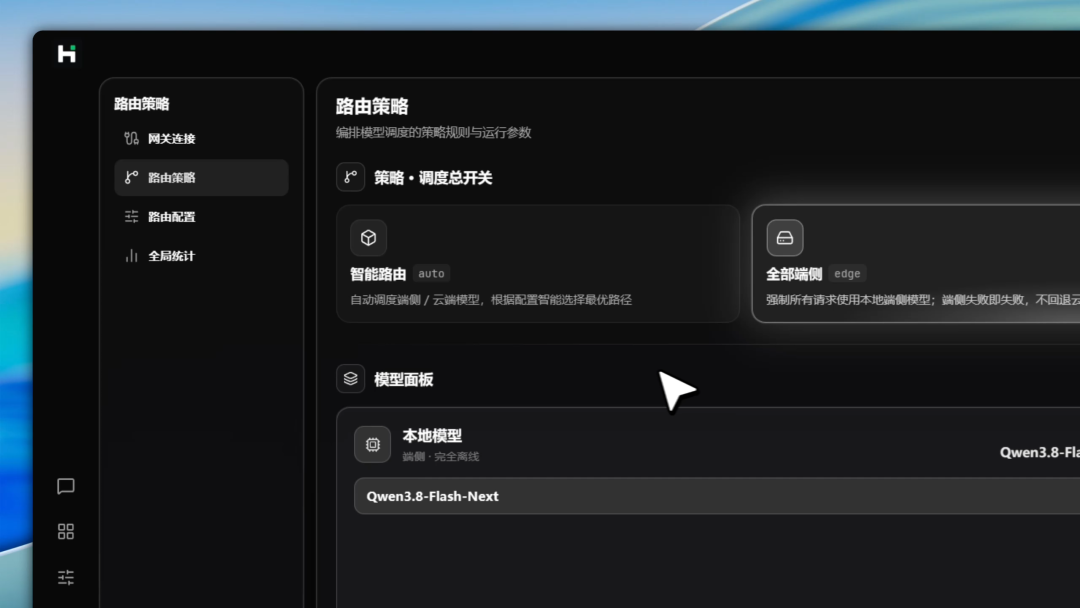
配置完成后,WorkBuddy 里所有的对话、编程、画图请求,都由这台 AMD 395 上的 Qwen3.8-Flash-Next 本地处理,数据不出机器,没有 token 费用消耗。
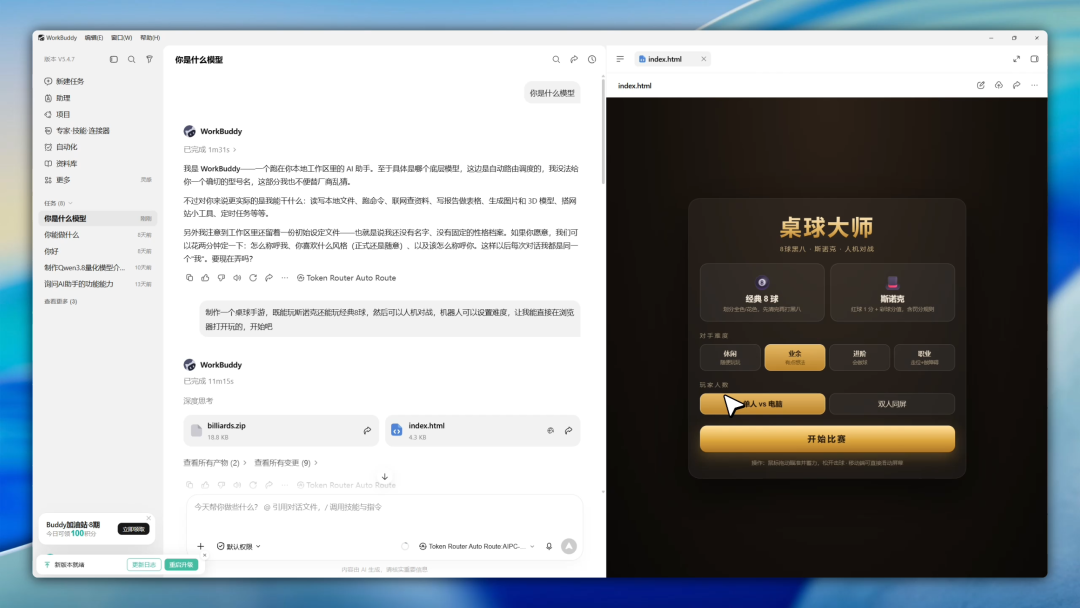
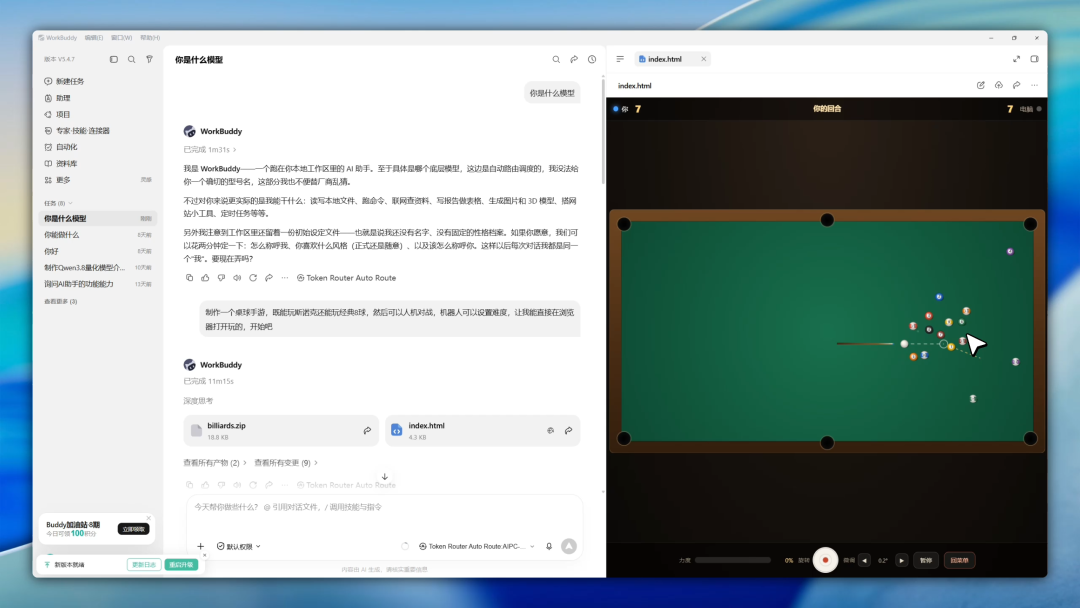
然后我让它开发了一个小游戏:做一个能人机对战的桌球游戏。
12 分钟。从需求描述到可玩的完整游戏:球桌渲染、击球力度、角度计算、AI 对手走位、胜负判定,一次成型。全程零报错,不需要我改一行代码。
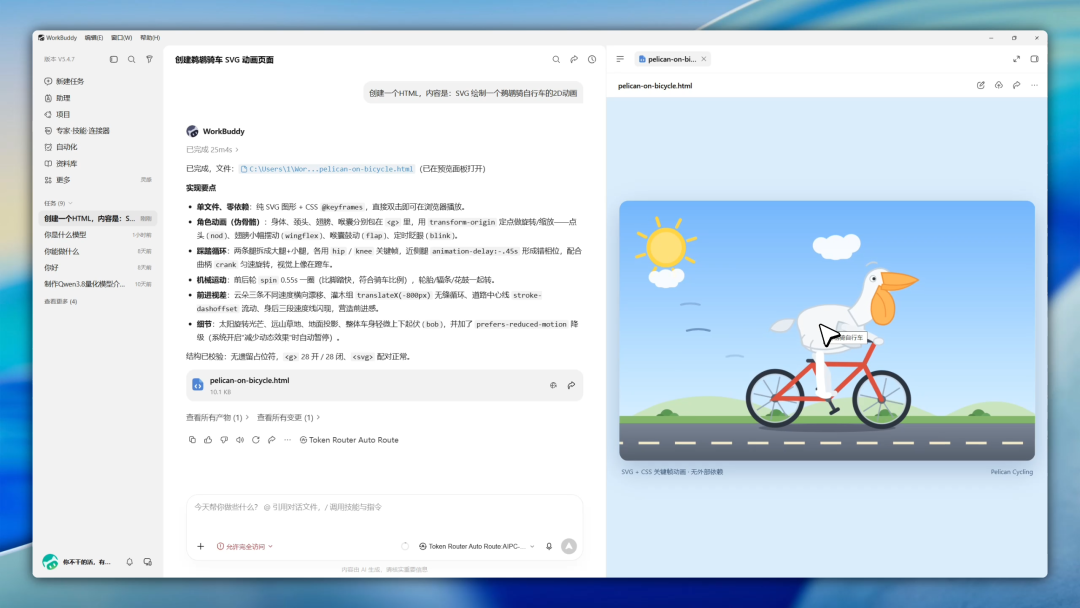
紧接着,我又丢给它那道经典的模型能力"试金石":画一只鹈鹕骑自行车的 2D 动画。
这道题难在哪?鹈鹕的大嘴、蹬车的腿部关节、车轮转动与前进的位移匹配,全是细节。模型交出的答卷:SVG + CSS 关键帧动画, pedal 蹬踏、腿部屈伸、车轮旋转三个动作全部同步到位,还有太阳、云朵和滚动路面,直接浏览器打开就能看。
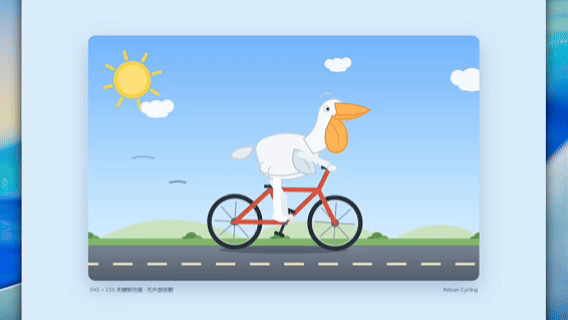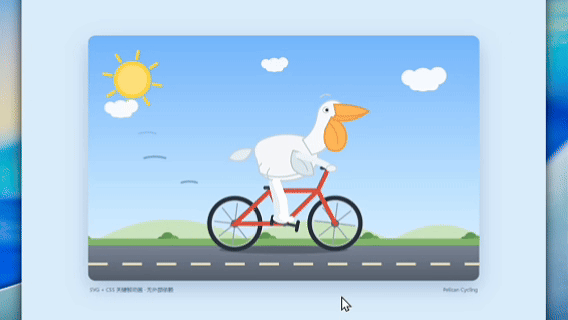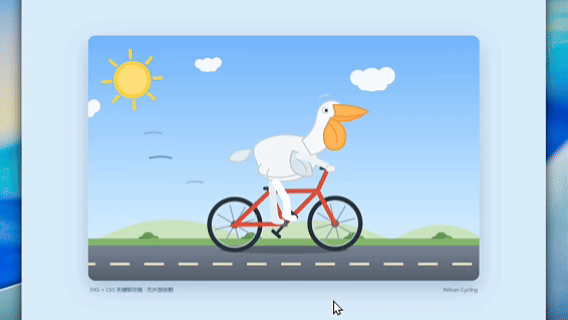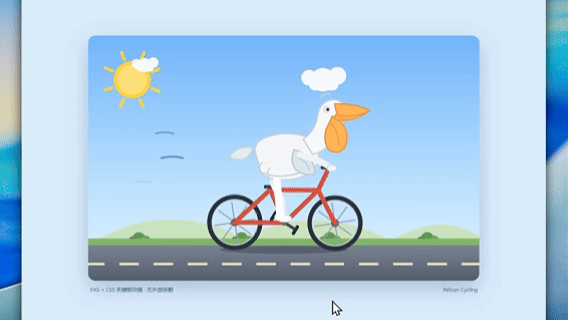
这两个演示证明的事情,比测试性能重要得多:本地部署模型不再是只能聊聊天了。
06 端侧 AGI 时代,来了
最后,给这次实测下一个完整的结论。
Qwen3.8-Flash-Next,真的很香。
180B 总参的底子、6B 激活的效率、原生 256K 上下文、原生多模态,在 128GB 统一内存的 AMD 395 上跑出 20~21 t/s 的续写速度——识图能打、代码能写、Agent 能接,而且这一切,跑在一台没有独立显卡、插着电就能用的安静小主机上。
如果说云端模型的 AGI 时代,是 GPT-6 Astra 带来的;
那么端侧模型的 AGI 时代,就是千问 3.8 引领的。
云端解决"多聪明",端侧解决"多亲近"。当 180B 的智能可以装进一台 128GB 的主机,AI 才真正从"云上的服务",变成"桌上的伙伴"。
这一步,已经迈出来了。
本文转载自微信公众号「技术不求人」,仅供学习交流使用。
觉得内容不错?我要