
基于 Playwright + Midscene实现 UI 自动化|DOM 定位 + 视觉识别 互补方案
本文来源: Raina(公众号:Raina)
原文链接: https://mp.weixin.qq.com/s/cPcDdXFcH3Qb5SeZNoEA-Q
发布时间: 2026-09-22 07:57
作者: Raina 发布时间: 2026-09-22 07:57
此前我们基于 Playwright CLI + Test 搭建 UI 自动化方案,但落地过程中遇到不少边界场景:Canvas/WebGL 图表、封闭 Shadow DOM、图形验证码等难以定位的页面元素。
针对这类问题,我们选择降级方案:引入 midscene.js,依托它的视觉识别能力编写自动化脚本。
有人会疑惑:为什么不直接使用本地 AI Agent 多模态能力,还要额外接入 midscene?
核心原因是:我们需要脚本能够在 CI 流水线、云端环境稳定运行,本地 AI Agent 多模态方案并不适配这类执行环境。
今天这篇,是对旧方案的一次升级:把 Playwright 和 midscene.js(视觉识别兜底) 融进同一套 Skill,让「能定位的走 DOM,不能定位的走视觉」,并且脚本还能在流水线里复用。
方案介绍
针对上述痛点,我对 UI 自动化 Skill 做了迭代,把两套能力放进同一条流水线:
自然语言 / 用例 → 探索页面 → 产出探索报告(用例矩阵 + 代码映射)
→ 按映射生成 Page Object + 测试脚本(DOM 用 Playwright,视觉用 midscene)
→ 配置 .env → 本地/流水线执行 → 失败自动修复 → Playwright 报告 + midscene 报告
涉及skill
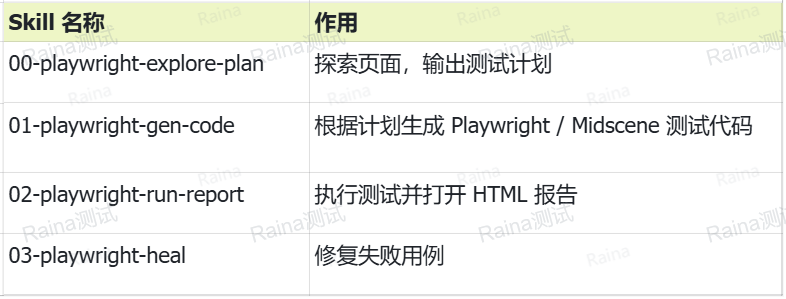
Skill获取方式见文末
实操案例
1、探索&计划生成
这里大家也可以直接提供更详细的用例,AI 则会基于用例去探索界面,如果没有提供的话,它就会直接去探索页面信息,生成用例
输入案例:
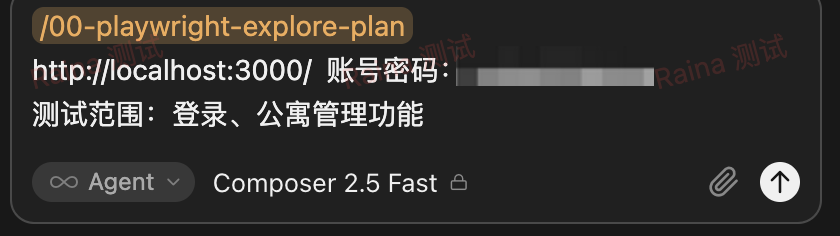
之后会使用 playwright cli(默认使用无头的方式),进行页面的探索,然后产出一份探索报告(md 文件):
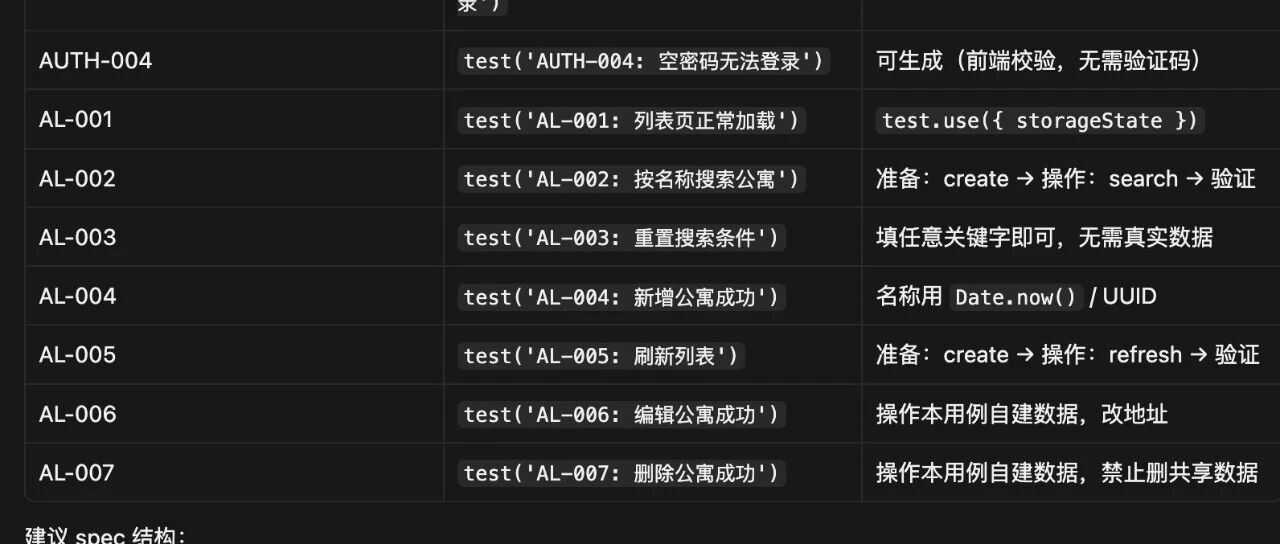
- 代码映射表
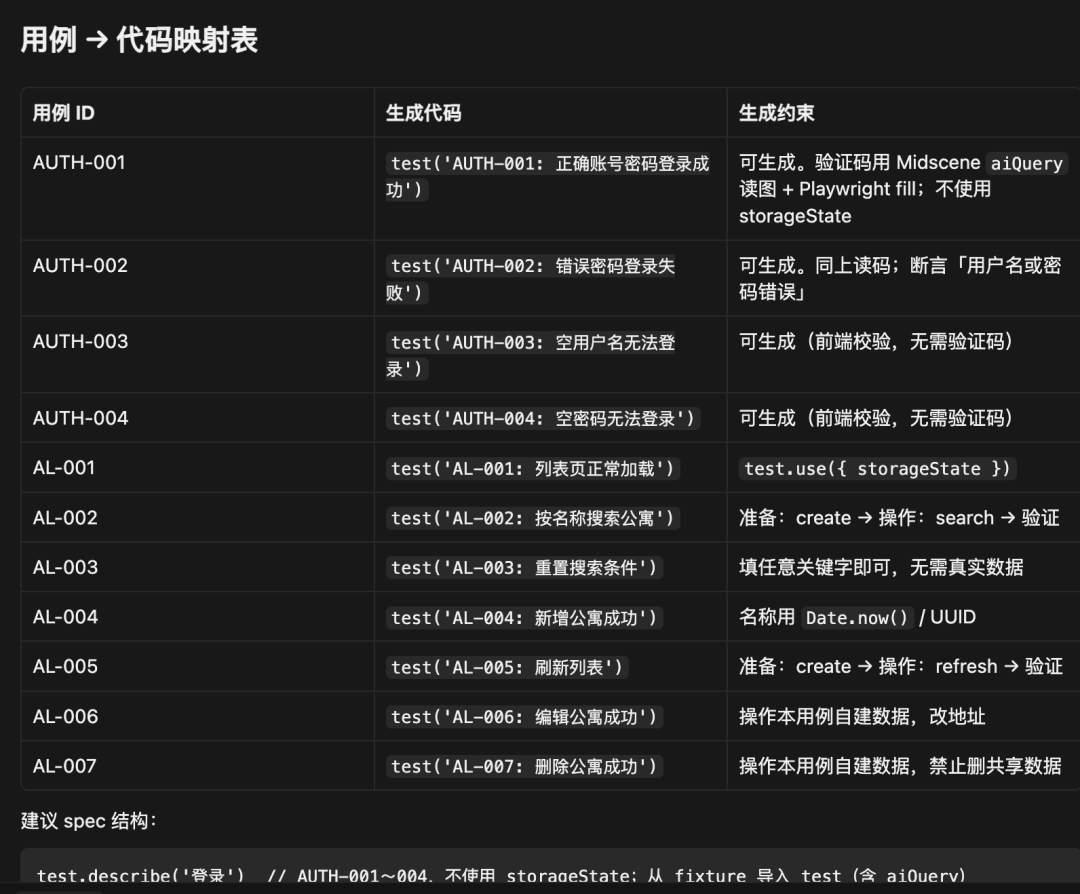
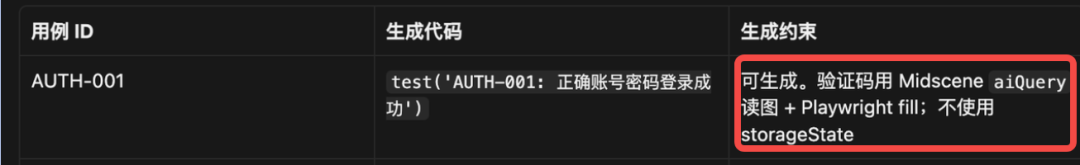
对于验证码,采用的是 midscene,因为这类图形类验证码,Playwright 无法直接识别
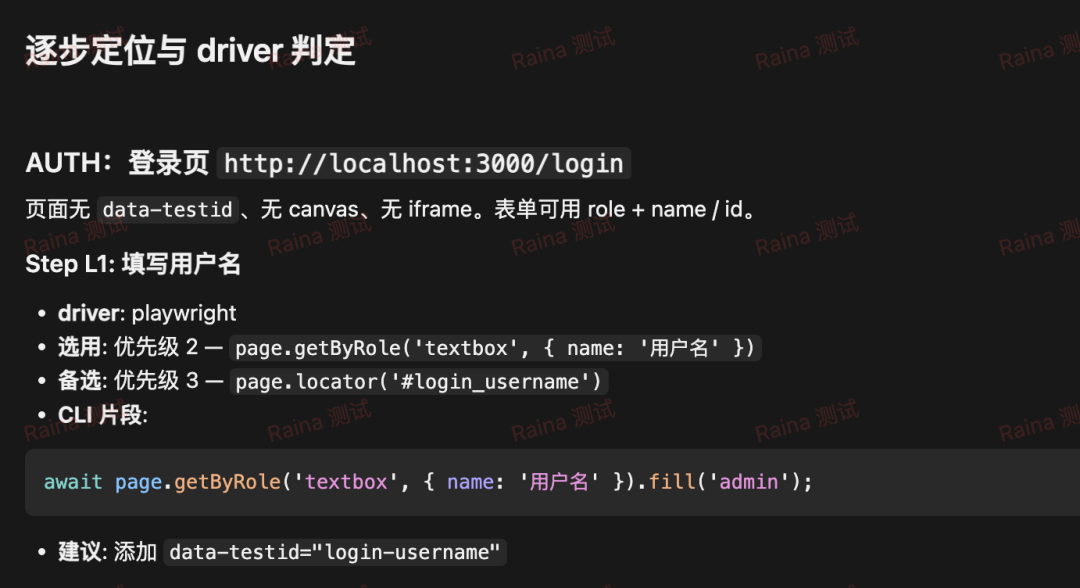
- 定位和驱动的逐步分析
如果大家担心 AI 的质量问题,且具备一定UI 自动化基础的话,则可以直接预览这个判定,对有误的部分做调整,从而可保证输出代码质量;当然也可以不看,在后面执行的时候出现问题的时候再修复也是 OK 的。
2、生成代码
在计划没问题之后,就可以产出代码了
执行下面的 Skill
产出代码,会根据不同的代码模块封装不同的 page
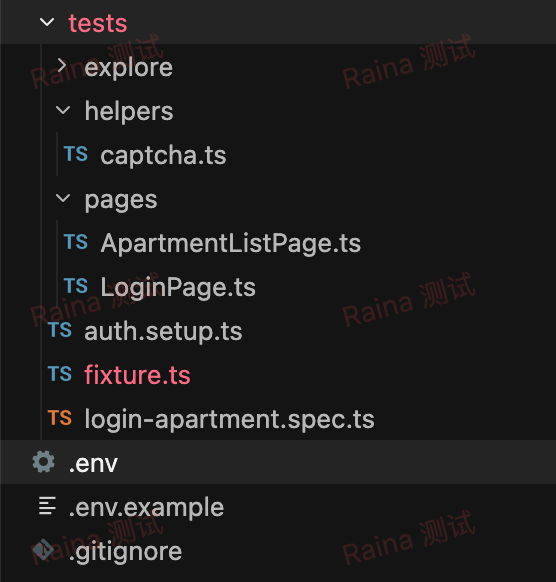
编写UI 自动化脚本
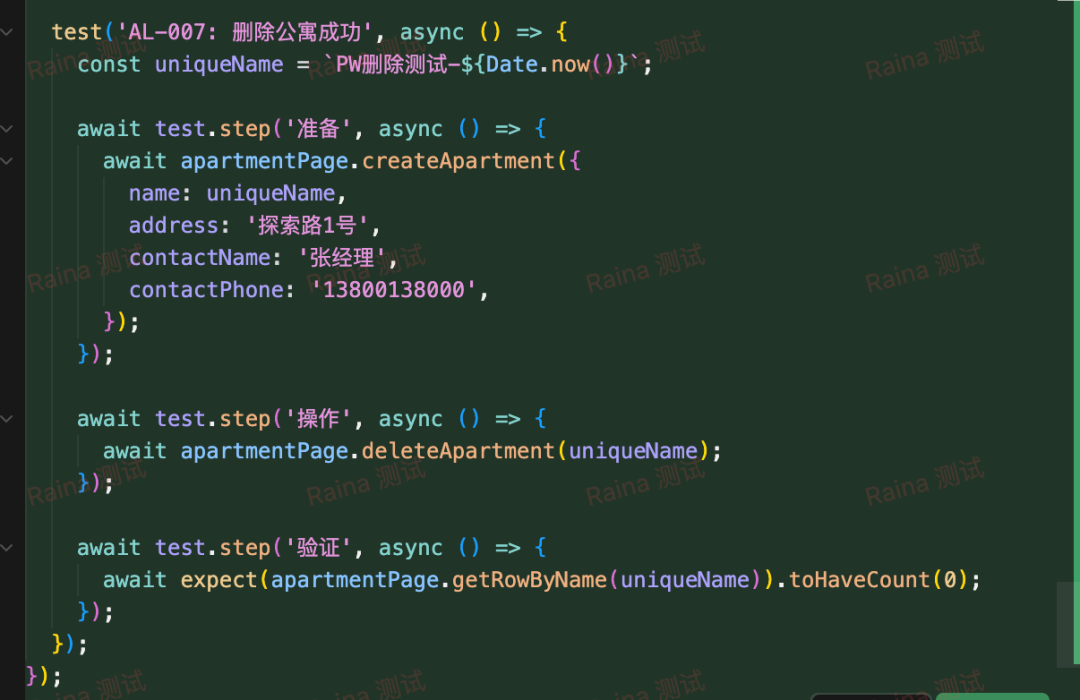
3、环境配置
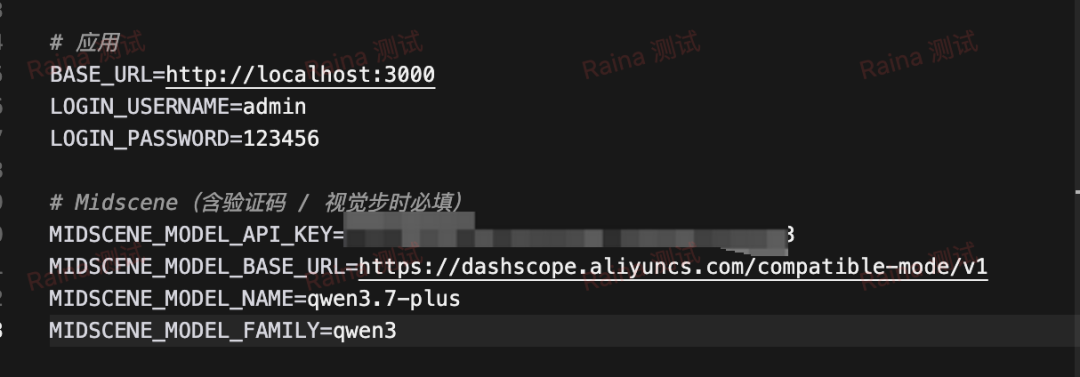
复制一份.env.example,然后文件名称修改为.env
填写 midscene 的变量,如:下面我用的多模态是qwen3.7-plus
4、执行脚本
这个主要是用于本地调试的 Skill,如果在流水线中执行的话,一般就直接使用命令去执行
输入:
输出案例:
例如我第一次执行,是有存在失败的
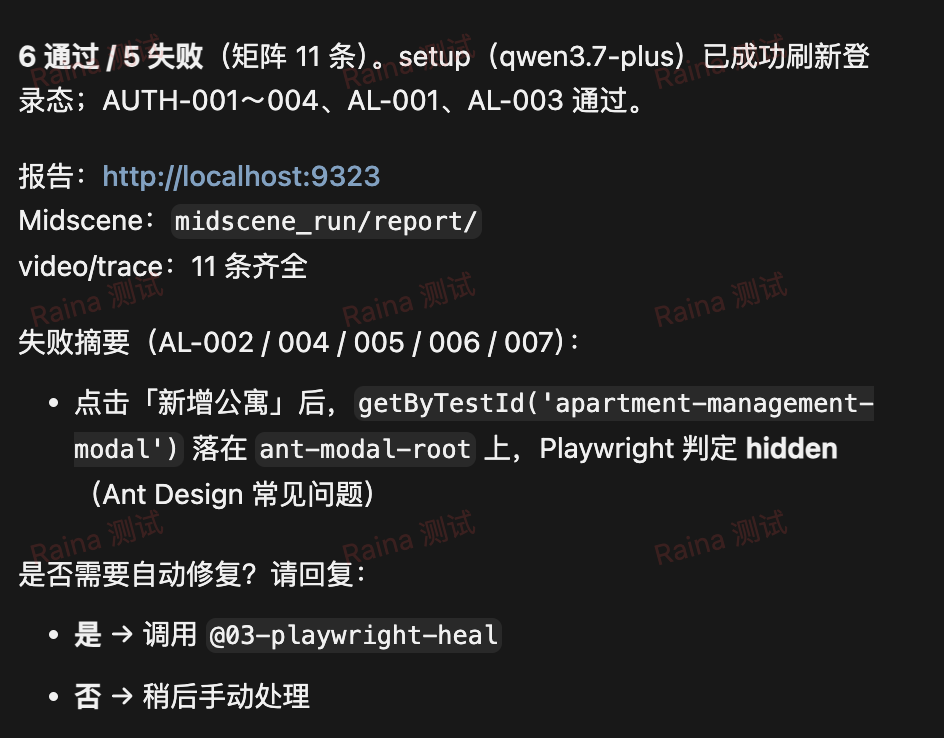
5、脚本修复
这里我们对代码进行修复,可以在上面的同个会话中,回复:“是” 或者执行
之后 AI 会根据上面的信息,对脚本进行修复,并重新调试
调试完之后,我们可以看下结果
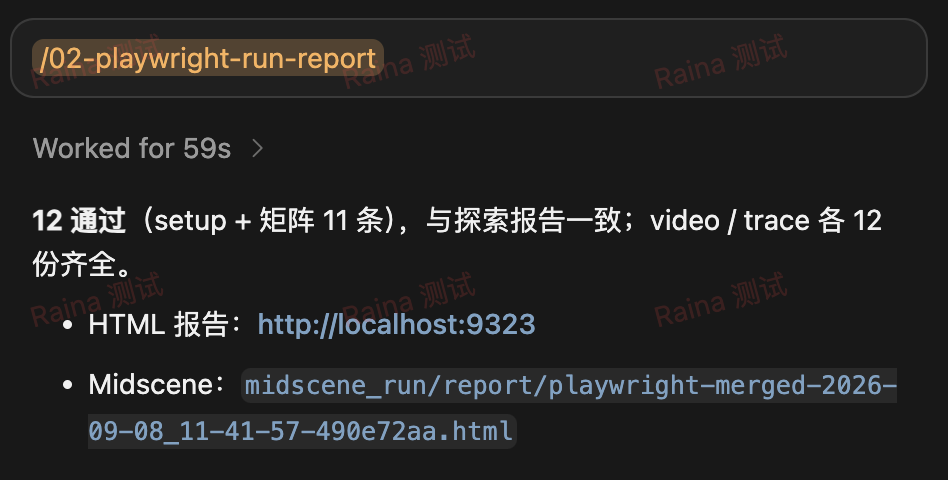
6、查看报告
默认访问:http://localhost:9323 即可,采用的依旧是 playwright test 的报告
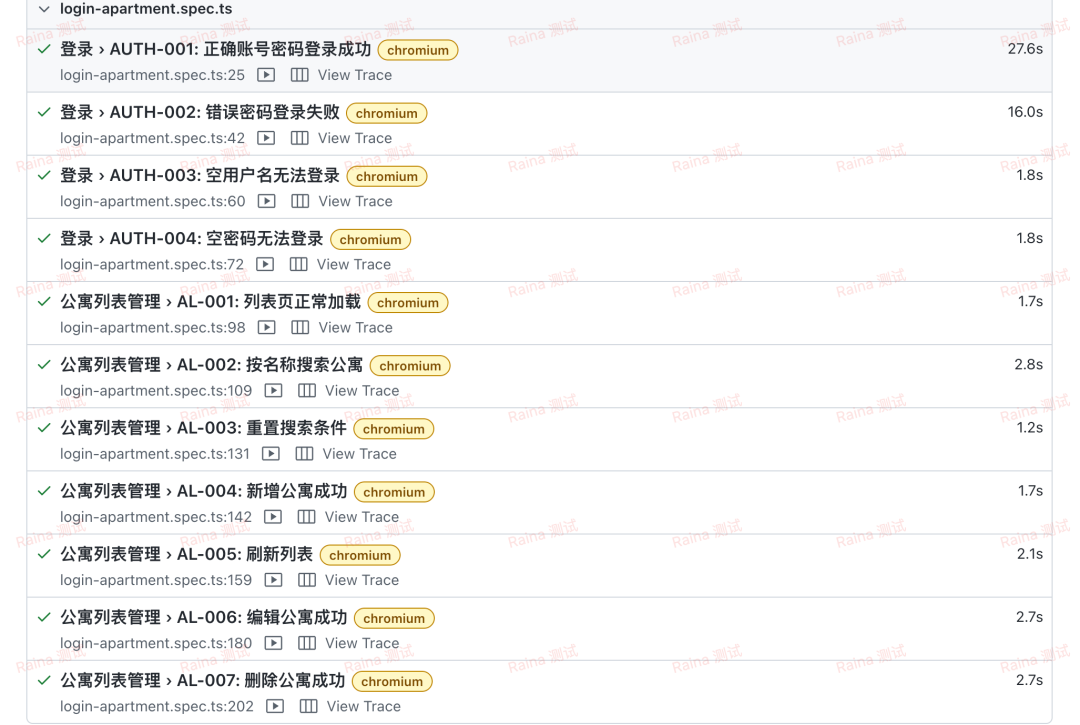
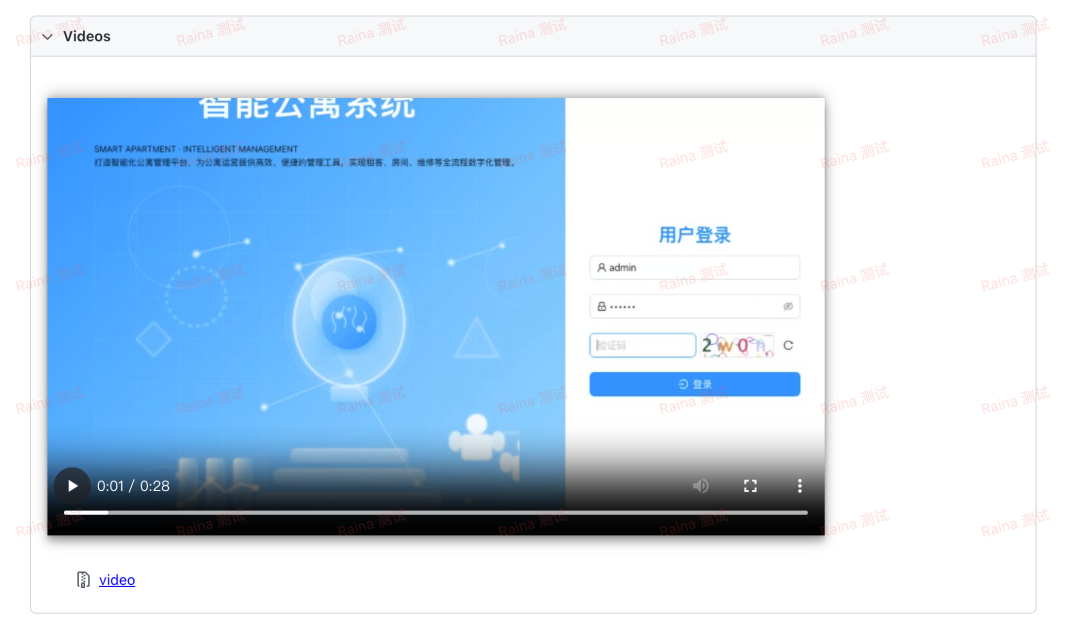
支持查看视频
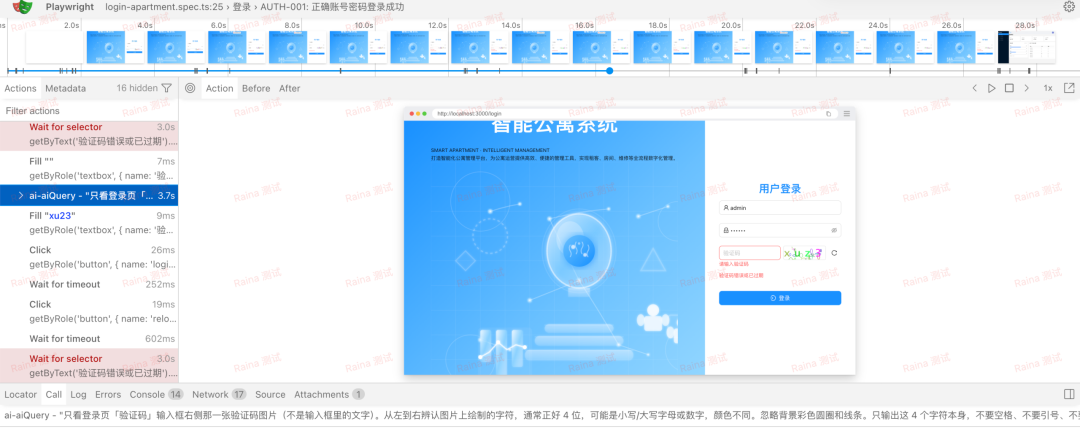
记录 trace,执行步骤等
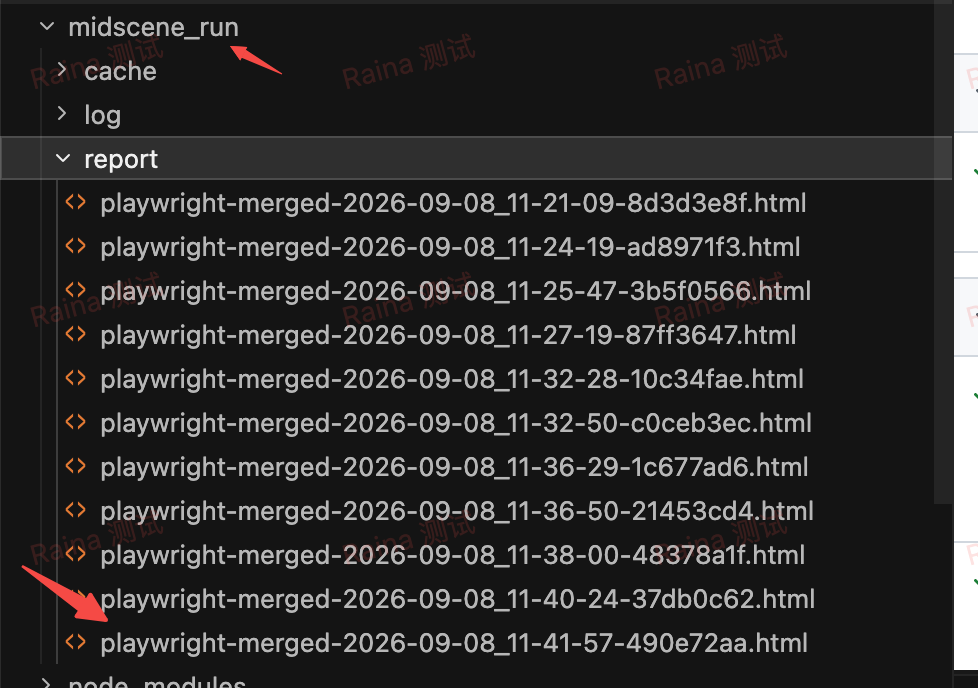
也可以打开 midscene 的执行报告
效果如下
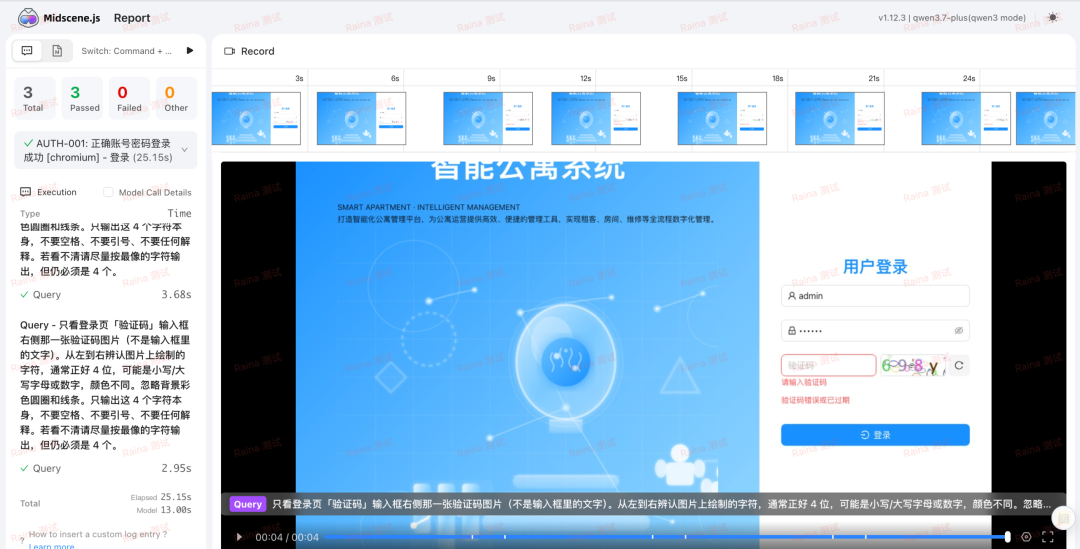
当然,这里多模态的执行也不是十分准确的,不是一次性识别成功,像我上面这个,使用 qwen3.7-plus,识别了 3 次才将图片中的验证码识别出来
以上是今天分享的内容,把 Playwright 的稳和 midscene 的视觉能力合进一套 Skill,边界场景也能写出可进 CI 的 UI 脚本。完整教程和 Skill 包已整理在【Raina的AI&测试实战圈】知识星球,跟着步骤操作就可以上手。感兴趣的小伙伴可以加入了解哦~
本文转载自微信公众号「Raina」,仅供学习交流使用。
觉得内容不错?我要