
AMD终于有自己的本地 Agent 了?395这次真能干活吗
本文来源: ddddaishare(公众号:ddddaishare)
原文链接: https://mp.weixin.qq.com/s/RwKYFcRoyQTzVrAiReDxZQ
发布时间: 2026-09-19 18:02
作者: ddddaishare 发布时间: 2026-09-19 18:02
前几天写 AMD,我还在讲驱动、ROCm 和 Windows 支持。今天换个更接近用户的问题。
AMD 自己有没有一套能在电脑上跑起来的 Agent?理想状态是能读文件、查资料、调用工具,最后把结果交出来,不止停在聊天框里。
答案是有了,名字叫 GAIA。
AMD 把它放在了自己的 GitHub 组织里,定位是 Ryzen AI 的本地 Agent 框架。默认走本地推理,支持 Ryzen AI 的 NPU 和 iGPU;想接云端,也可以通过 Lemonade 配 Fireworks 或 AMD LLM Gateway。这个项目今天最值得看的地方,就是它没有把“本地”只理解成一个聊天窗口。
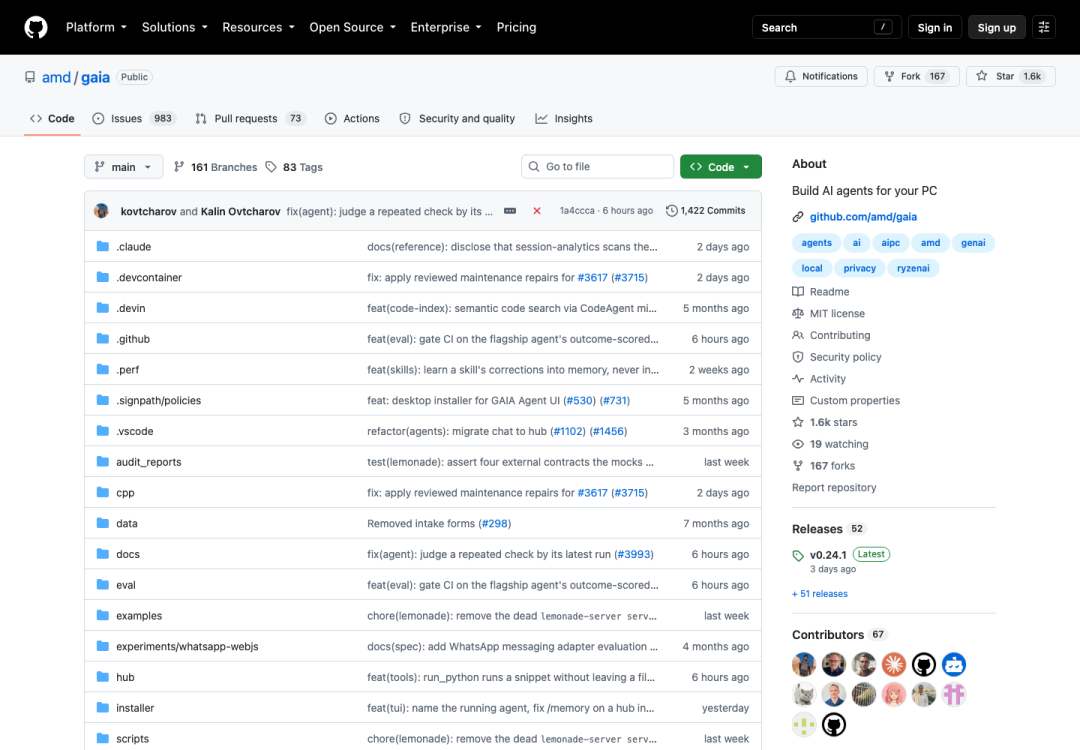
AMD GAIA 官方 GitHub 项目页面
GAIA 的功能清单里已经有几个很实用的东西。桌面界面可以聊天、浏览文件、给文档建索引、执行工具;RAG 支持 50 多种文件格式;语音部分接 Whisper 和 Kokoro;视觉部分接 Qwen3-VL-4B;还可以通过 MCP 接外部工具。
换句话说,一台 Ryzen AI 电脑可以先做一个“本地资料助手”,再慢慢加工具,不用一开始就搭一套复杂的 Agent 平台。
这对 Ryzen AI Max+ 395 用户尤其有意思。395 的优势在于大统一内存能把更大的模型和文档放在同一台机器里,NPU 单点速度只是其中一部分。GAIA 负责 Agent 的工具编排,模型和资料留在本机,适合做企业内部资料检索、代码仓库问答、离线文档处理这类事情。
但别把它理解成“395 终于能跑出云端顶级 Agent 速度”。GAIA 是框架,速度和能力仍然取决于你给它接的模型、推理后端和工具数量。大模型放得下,不等于每一步都快;Agent 还会重复读文件、调用工具、等待返回,实际体验比单轮聊天更容易被上下文和 I/O 拖慢。
AMD 官方给的最低配置是 Ryzen AI 300 系列处理器、Windows 11 或 Linux、16GB 内存;推荐配置是 Ryzen AI Max+ 395 和 64GB 内存。这个门槛说明,GAIA 并不是只给 395 用,但大内存机器会更舒服。
安装先别想复杂,官方仓库给的是 Python 包路线。
pip install amd-gaia安装完成后,可以先跑终端界面,再用 /provider 选择本地或云端提供方。接云端后,聊天历史会发给对应服务商;只有本地模型路线才符合它“默认本地”的隐私设定。
如果你想自己写一个小 Agent,官方示例直接继承 Agent、注册工具就能跑。
from gaia.agents.base.agent import Agent from gaia.agents.base.tools import tool class MyAgent(Agent): def _get_system_prompt(self) -> str: return "You are a helpful assistant." def _register_tools(self): @tool def get_weather(city: str) -> dict: return {"city": city, "temperature": 22, "conditions": "Sunny"} agent = MyAgent() print(agent.process_query("What's the weather in Shanghai?"))还有一个更直接的配套项目叫 Ryzen AI LLM Server。它把 Ryzen AI 300/400 系列上的模型暴露成 OpenAI 兼容接口,支持 NPU、NPU+iGPU 混合和 CPU 三种模式,还支持工具调用和流式输出。
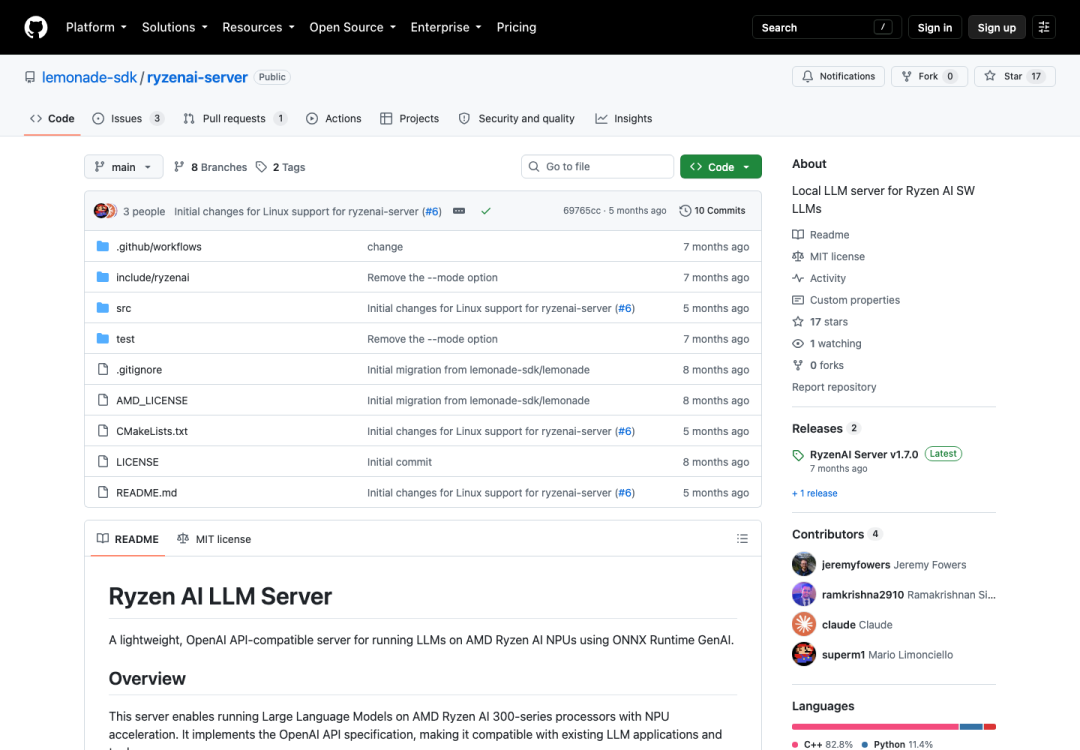
Ryzen AI LLM Server 官方仓库页面
Windows 上的基本构建流程是这样。
git clone https://github.com/lemonade-sdk/ryzenai-server.git cd ryzenai-server mkdir build cd build cmake .. -G "Visual Studio 17 2022" -A x64 cmake --build . --config Release它要求 Windows 11、Visual Studio 2022、CMake 3.20 以上,以及 Ryzen AI Software 1.7.0。硬件方面,NPU 路线要求 Ryzen AI 300 或 400 系列,内存最低 16GB,大模型建议 32GB 以上。
如果你手里是普通 Ryzen AI 300 系列笔记本,也可以先从语音这个入口试起。AMD 的 LIRA 项目可以把 Whisper 和 Zipformer 导出、优化并放到 CPU、GPU 或 NPU 上运行,还能开一个 OpenAI 兼容的转写接口。
git clone https://github.com/aigdat/LIRA.git cd LIRA pip install -e . lira run whisper --model-type whisper-base --export --device npu --audio input.wav这就能做一个本地会议录音转写,再把文字交给 GAIA 总结。相比一上来让 395 跑一个很大的 Agent,先把“录音转写、文件检索、结果整理”这一套流程跑通,更容易知道机器到底够不够用。
我建议 AMD 用户按三层来搭。第一层是本地模型和推理后端,先确认模型确实在 NPU、iGPU 或 CPU 上工作;第二层是 GAIA,负责文件、RAG、MCP 和工具调用;第三层才是自己的工作流,比如会议纪要、代码仓库问答、资料归档。
还要提前说清楚几个限制。GAIA 的官方仓库还在持续开发,部分功能和模型导出属于早期能力;Ryzen AI LLM Server 的 DLL 还要遵守 AMD 软件许可;LIRA 也明确提醒,部分 NPU 后端是实验性质。把它当成今天就能拿来搭原型的开源底座可以,直接当成熟企业平台就过头了。
项目入口放这里,建议从官方 README 开始。
AMD GAIA https://github.com/amd/gaia Ryzen AI LLM Server https://github.com/lemonade-sdk/ryzenai-server AMD LIRA https://github.com/amd/LIRAAMD 本地 AI 今天比较实在的利好,是开始把模型、NPU、文件检索、工具调用和 OpenAI 兼容接口拼成一套东西,不再只停留在“理论上能跑”的模型层面。
395 适合拿来做大一点的本地资料和 Agent 原型,普通 Ryzen AI 300 系列也能从语音、转写和轻量 RAG 入手。先让机器稳定地完成一个小任务,再往上堆模型和工具,比一开始就追求“本地版超级 Agent”靠谱得多。
资料核对。AMD GAIA、Ryzen AI LLM Server、AMD LIRA 官方仓库,按 2026 年 9 月 19 日页面内容整理。
本文转载自微信公众号「ddddaishare」,仅供学习交流使用。
觉得内容不错?我要