
什么是算子?别再只看算力参数
本文来源: IT孙磊(公众号:IT孙磊)
原文链接: https://mp.weixin.qq.com/s/-jTuM8gPyohcEonLUZVYnQ
发布时间: 2026-09-09 07:14
作者: IT孙磊 发布时间: 2026-09-09 07:14
本期摘要
很多人评估AI芯片只看算力参数,实际部署却发现性能差几倍。核心问题在算子——AI计算的标准化工序。本文用"厨房工序"类比,讲清楚算子是什么、大模型最常用的5类算子、为什么纸面算力和实际性能会有巨大差距,以及工程落地真正要关注的三件事。
很多人看 AI 芯片参数,第一反应就是看算力多少 TOPS。实际部署才发现,参数差不多的两张卡,性能能差几倍。问题就出在算子上。
用厨房工序理解算子
举个生活里最直白的例子:把 AI 芯片想象成一个厨房。
- GPU/NPU 芯片 = 厨房,有灶台、刀、锅,硬件条件很强。
- 算子 = 一个个标准化菜谱工序
:洗菜、切菜、切丝、焯水、翻炒、调味。
- 张量 = 食材(肉、蔬菜、调料)
。
厨房硬件再好,如果没有工序,什么菜也做不出来。每一道工序,就是一个算子。
大模型没有什么神秘的 "思考魔法"。它不会自己理解文字,只会把整个模型拆成一大堆固定工序,按顺序一遍一遍执行。
输入食材(张量)→ 执行工序(算子)→ 得到半成品 → 交给下一道工序(下一个算子)→ 反复加工,最后输出成品(生成回答)。
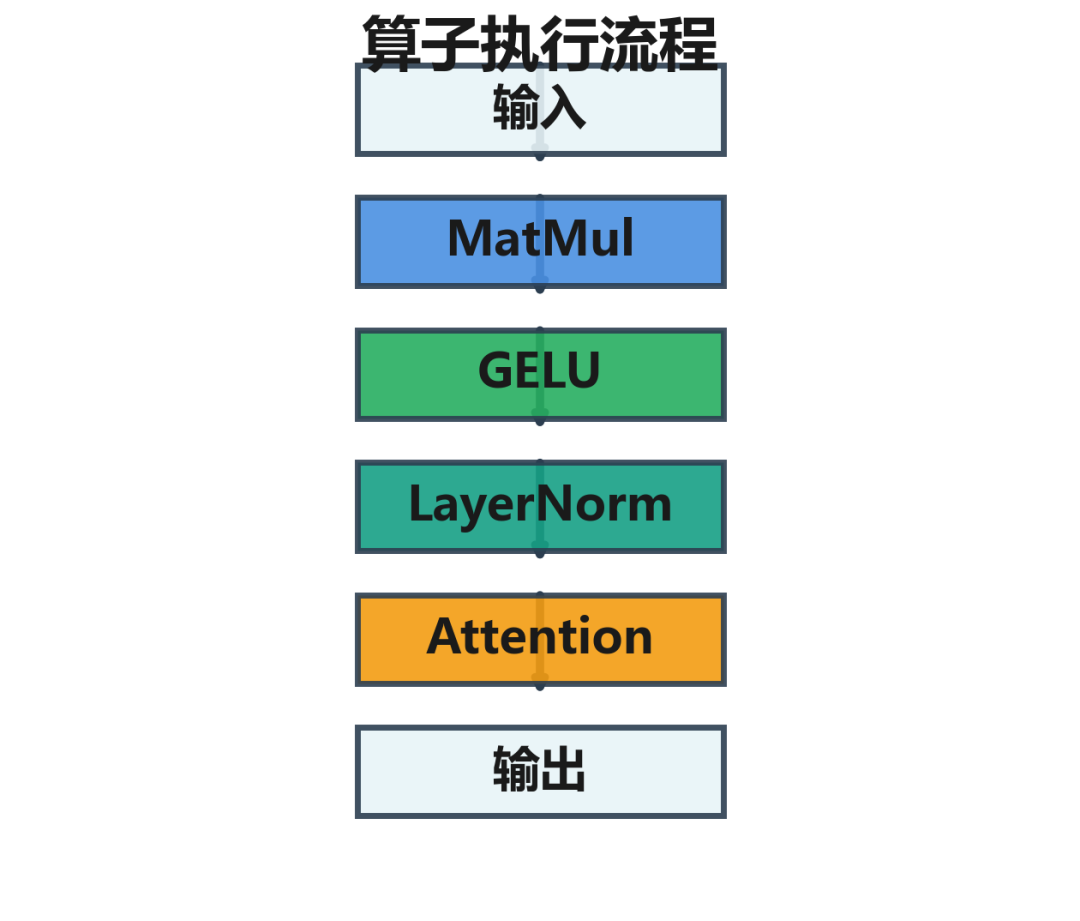
▲ 算子像流水线一样串联执行,每个算子处理一种特定运算
大模型最常用的 5 道"工序(算子)"
1. 矩阵乘法 MatMul:大刀剁肉、主翻炒
厨房里面工作量最大的工序,整个模型 80% 活都是它干的。模型里面所有的知识权重,全部靠这一步做计算。这是绝对主力工序。
2. 激活算子 GELU/SiLU:调味
光翻炒出来只是生熟变换,加调料才有味道。激活算子就是给计算加入非线性变化。没有它,AI 只能做简单算数,理解不了语言。
3. Attention 注意力算子:比对食材搭配
专门用来判断文字和文字之间的关系。比如读长句子,哪几个词互相关联,全靠这道工序。长文本慢,大多就是这道工序跑的慢。
4. LayerNorm 归一化:把控咸淡
防止味道过咸过淡,把数值控制在安全范围。工作量不大,但不能缺,缺了直接做坏菜。
5. 元素级算子:切葱花、剥蒜
都是零碎小活,单次很快,但是数量巨多。活太多的时候,来回调度也会拖慢整体速度。
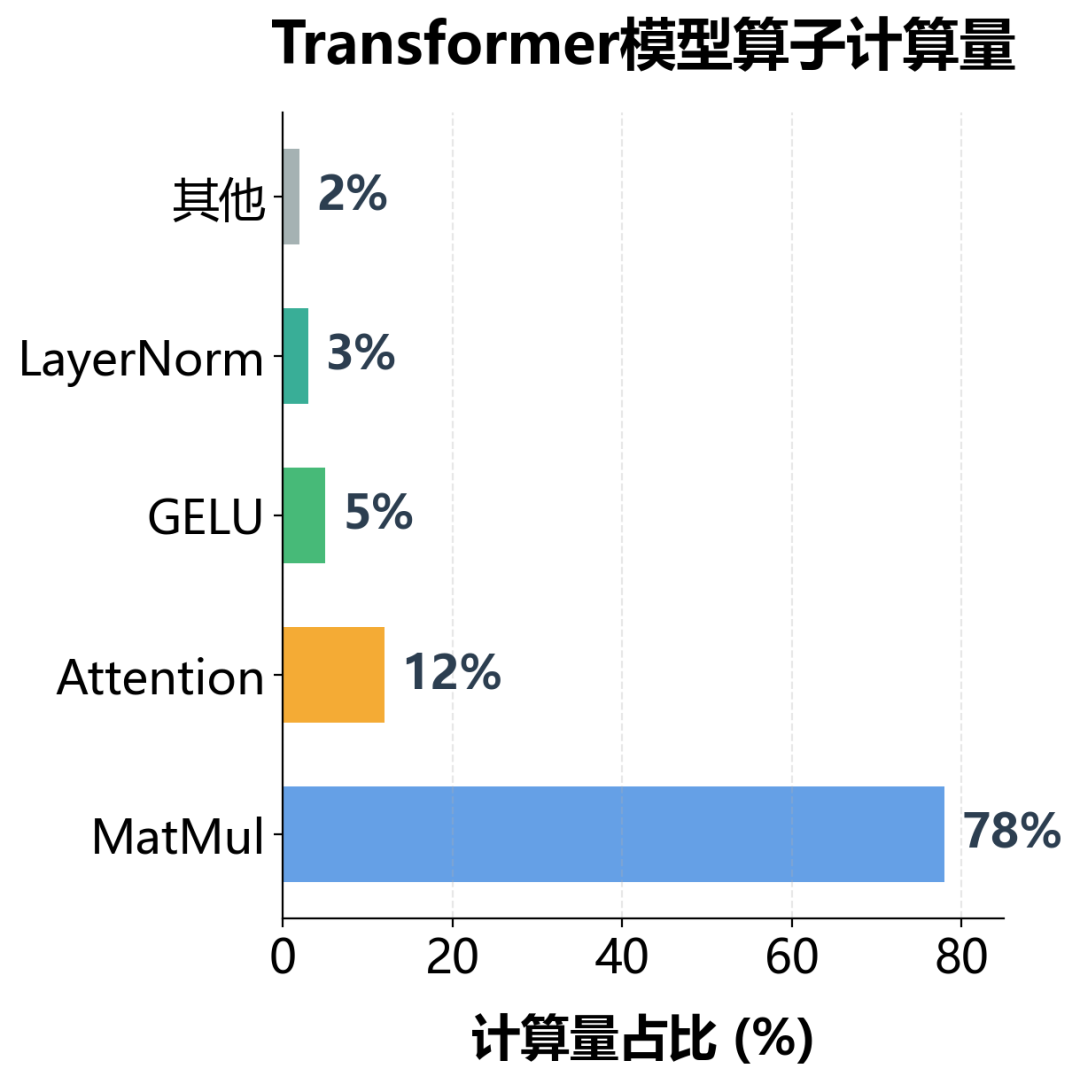
▲ MatMul占据了大模型推理80%左右的计算量,是绝对的核心算子
为什么跑分高,实际跑起来不行?
跑分相当于厨房做最简单的白水煮菜,只看灶台火力多大(峰值算力)。真实跑大模型,是要完整做一桌子菜,需要上面全套工序。
- 成熟算子库
:每一道工序都经过千锤百炼,刀工火候全部优化到位,硬件能力充分发挥。
- 算子做的差
:有的工序缺失,有的工序效率低下。灶台火力再猛,切菜慢、翻炒笨,整体出菜速度依然上不去。
这就是英伟达 CUDA 的核心价值:不是灶台硬件无敌,是几十年打磨出来一整套优化到极致的工序库。国产芯片很多硬件纸面火力不差,但部分工序要么缺失,要么做的粗糙,上线就暴露问题。
CUDA生态的护城河
英伟达的 cuBLAS、cuDNN 这些算子库,不是简单把算法实现一遍就完了。每个算子都有几十个甚至上百个不同的实现版本,针对不同的:
- 硬件架构
:V100、A100、H100 每一代 GPU 架构不同,算子都要重新优化。
- 数据精度
:FP32、FP16、INT8、INT4,不同精度有专门的快速路径。
- 矩阵形状
:方阵、长条矩阵、超大矩阵,每种形状最优算法都不一样。
- 批处理大小
:Batch=1 和 Batch=32 的优化策略完全不同。
CUDA 库会在运行时自动选择最优的实现版本(Auto-tuning),这套机制需要大量的工程积累和性能数据支撑。国产芯片厂商想要追上,不是几年能做到的。
算子融合:1+1>2 的黑科技
单个算子优化到极致还不够,真正的性能提升来自算子融合。
举个例子:一个 Transformer 层里,LayerNorm → MatMul → GELU 这三个算子如果单独执行,每次都要把中间结果写回显存,再读出来。显存带宽是瓶颈,来回读写非常慢。
如果把这三个算子融合成一个 Fused Kernel,中间结果直接在寄存器或共享内存里传递,不经过显存。性能能提升 30-50%。
CUDA 的编译器和推理框架(TensorRT、FasterTransformer)已经内置了大量的融合算子。国产芯片这方面差距更大,很多常见的融合模式都没实现。
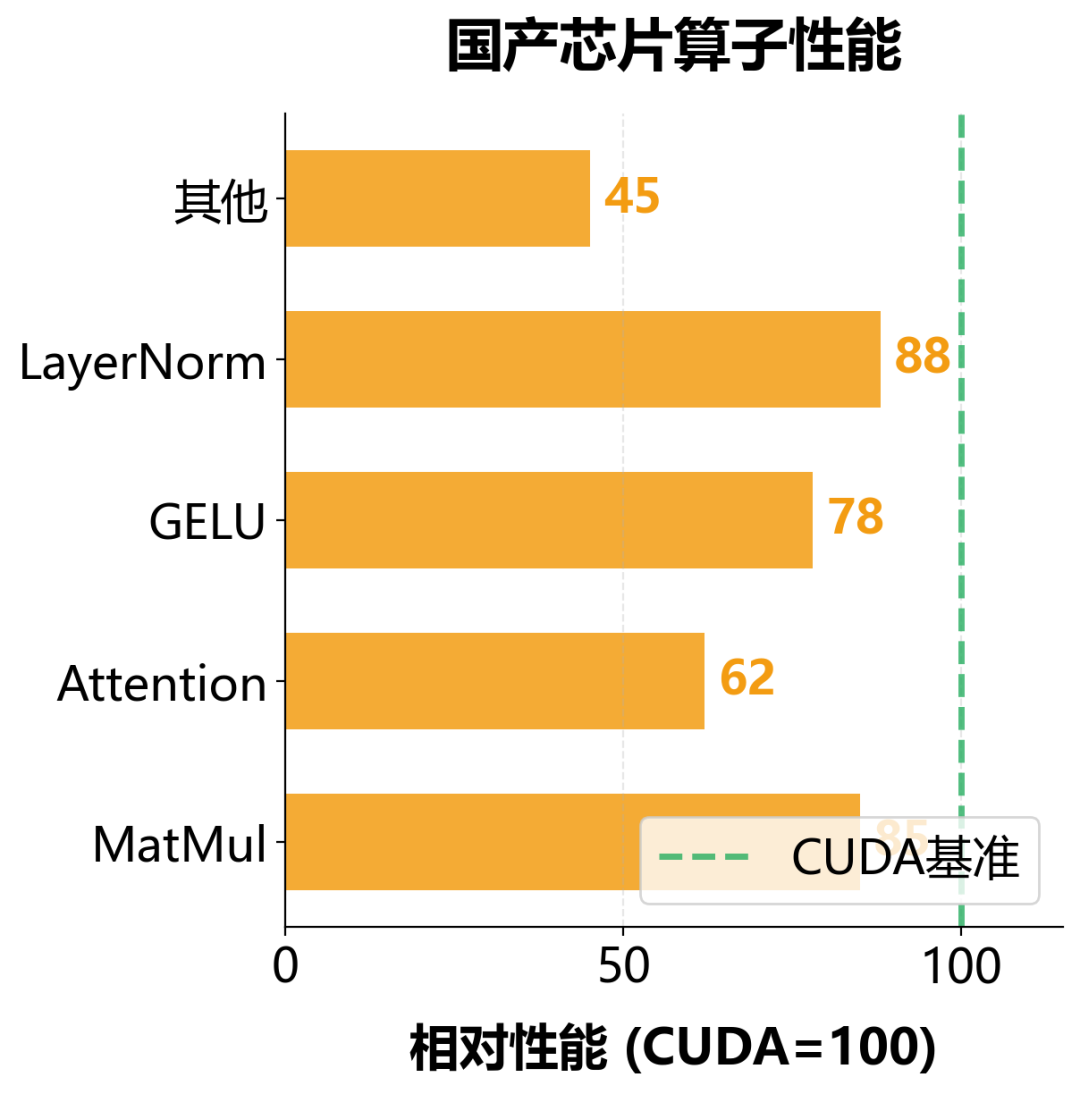
▲ 同样的算子,不同算子库的性能差异可达2-3倍
工程落地要关注三件事
- 工序齐不齐(算子覆盖)
:跑这个模型需要的全部工序,芯片是否都支持。缺一道,直接做不出菜,模型跑不通。
- 工序快不快(算子性能)
:同样一道切菜,有的刀工快,有的刀工慢。同样算子运行延迟多少,才是真实性能。
- 处理变化食材稳不稳(动态 Shape)
:线上用户输入长短不一,相当于食材大小每次不一样。静态测试跑通不算本事,长短变化的时候工序依然稳定高效,才可以上线。
算子覆盖:别等上线才发现缺算子
最尴尬的情况:模型转换完,推理框架加载成功,看起来一切正常。跑起来才发现某个算子不支持,整个流程卡死。
常见的坑:
- 新激活函数
:模型用了 SwiGLU、GeGLU 这类新激活,芯片只支持传统的 ReLU、GELU。
- 自定义算子
:研究团队魔改了模型结构,加了自己写的算子。开源推理框架不认,得自己写实现。
- 算子融合
:单个算子都支持,但某种特定组合没优化。比如 LayerNorm + MatMul 融合能省显存读写,但芯片没这个版本。
算子性能:测对指标才有意义
很多人测性能,只看端到端延迟。这不够,得拆开看每个算子的耗时占比。
重点看这几个指标:
| 指标 | 含义 | 参考值 |
|---|---|---|
| 算子延迟 | 单次执行耗时 | 与CUDA对比差距<30% |
| 显存带宽利用率 | 是否吃满带宽 | 计算密集型>70% |
| 计算单元利用率 | GPU/NPU占用率 | 大算子>80% |
| Kernel启动开销 | 启动算子的消耗 | <50微秒 |
动态Shape:线上才是真战场
测试环境都是固定输入:Batch Size=1,序列长度=512。看起来很快。上线之后,用户输入千奇百怪:
- 有人发一句话,10 个 token。
- 有人粘贴一整篇论文,8000 token。
- 批处理时,8个请求长度分别是 50、200、512、1024、2048、3000、4096、6000。
这叫 动态 Shape。算子每次处理的数据大小不一样,能不能依然高效?很多国产芯片在这上面翻车。
动态 Shape 的三个常见问题:
- 编译时优化失效
:很多算子针对固定大小做了 Kernel 优化,Shape 一变就回退到通用版本,性能直接腰斩。
- 显存碎片化
:每次输入长度不同,显存分配释放频繁,产生大量碎片,最后明明还有空闲显存却 OOM。
- Padding 浪费
:批处理时为了对齐,短序列被 Padding 到最长序列的长度。8 个请求里最长的 6000 token,其他 7 个都得 Padding 到 6000,实际计算量翻倍。
测试动态 Shape 的正确方法:生成 100-10000 token 的随机长度序列,连续跑 1000 次推理,统计 P50、P90、P99 延迟。如果 P99 比 P50 高 3 倍以上,说明动态适配有严重问题。
实战检查清单
选型或上线前,必须验证这些点:
| 检查项 | 怎么验证 | 不合格表现 |
|---|---|---|
| 算子覆盖 | 跑完整推理看日志 | 出现 fallback 或 unsupported 警告 |
| MatMul性能 | Profile看耗时占比 | MatMul 占比 >85%(正常应该 75-80%) |
| Attention性能 | 测试不同序列长度 | 长文本延迟非线性增长 |
| 显存管理 | 批处理压测峰值显存 | 实际占用超过理论值 30% |
| 动态适配 | 随机长度连续测试 | P99 延迟是 P50 的 3 倍以上 |
每一项不合格,都意味着上线后会踩坑。不要抱侥幸心理。
常见误区
- 算力越高速度越快 ❌<br/>算力只是灶台最大火力,真正上菜速度要看整套工序效率。
- 模型能加载就是适配完成 ❌<br/>能加载,只是厨房可以开门,不等于每道工序都高效。
- 性能不行就堆硬件 ❌<br/>很多时候是工序(算子)做的烂,单纯堆灶台没用。
本篇小结
- 算子就是 AI 计算里标准化的加工工序,芯片靠算子完成全部运算。
- 大模型绝大多数工作,就 5 类算子反复组合完成。
- 纸面峰值算力参考价值有限,算子的完整度、执行效率决定真实业务表现。
- 算子生态差距,是国产算力落地最现实的阻碍。
术语速查
| 名词 | 通俗解释 |
|---|---|
| 算子 Operator/Kernel | AI 芯片的标准化计算工序,所有运算的最小动作 |
| MatMul 矩阵乘法 | 工作量最大的核心工序,承担模型大部分计算 |
| 激活算子 | 给计算加入变化,让模型可以学习复杂语言逻辑 |
| Attention 注意力算子 | 分析文本之间关联,支撑长上下文对话 |
| 算子库 | 整套预优化好的工序合集,决定芯片实际性能 |
下期预告
- 什么是张量?AI 所有数据的唯一载体
算子是加工工序,张量就是被加工的食材。看懂张量,就能搞懂显存、OOM 这些经常遇到的问题。
看完有启发的话,点个"关注和❤️"再走
本文包含AI辅助创作内容,作者已审核并对全文负责
本文转载自微信公众号「IT孙磊」,仅供学习交流使用。
觉得内容不错?我要