
FP16、FP8、FP4和INT8 究竟改变了什么?
本文来源: AI拆解师(公众号:AI拆解师)
原文链接: https://mp.weixin.qq.com/s/70oLXyXZZesVkOHqeXTR9w
发布时间: 2026-08-23 12:10
作者: AI拆解师 发布时间: 2026-08-23 12:10
TOKEN生产技术专章 · 第14篇
FP16、FP8、FP4和INT8
究竟改变了什么?
量化如何降低Token成本
TOKEN · GPU · INFERENCE · SYSTEMS
量化常被描述成“把模型从16位压到8位或4位”,仿佛只要把每个数字砍掉几位,显存和延迟就会按比例下降。真实情况要复杂得多:权重、激活、KV Cache可能采用不同精度;浮点与整数的动态范围不同;缩放因子有per-tensor、per-channel、per-group或per-token;硬件是否有原生低精度Kernel,决定压缩能否变成速度。
这篇文章不做量化算法名词大全,而是回答一个更基础的问题:精度降低后,Token生产链上究竟哪些字节、哪些运算、哪些误差发生了变化?
一、位数减少,首先改变的是“一个数字占多少空间”
FP16/BF16通常每个元素2字节,FP8/INT8每个元素1字节,FP4/INT4在理想打包下约0.5字节。若只看一个拥有700亿参数的密集模型,权重从16位降到8位,原始权重字节约减半;降到4位,约降至四分之一。更小权重可以装进更少GPU,也可以为KV Cache和更大Batch腾出空间。
对Decode而言,更关键的是每一步需要搬运的权重字节。若权重带宽是瓶颈,减小字节数可能直接缩短单步时间。对Prefill而言,低精度还可能调用吞吐更高的Tensor Core路径,提高计算上限。但这些都是“可能”:实际还要加上Scale、Zero Point、元数据、对齐填充和反量化开销。
精度标签也不能只看数字。FP8保留指数位,适合表达跨数量级的值;INT8在固定尺度下均匀量化,范围与分辨率依赖Scale;FP4存在多种格式,例如硬件与框架对块尺度的定义可能不同。相同“4bit”并不保证相同表示能力或Kernel。
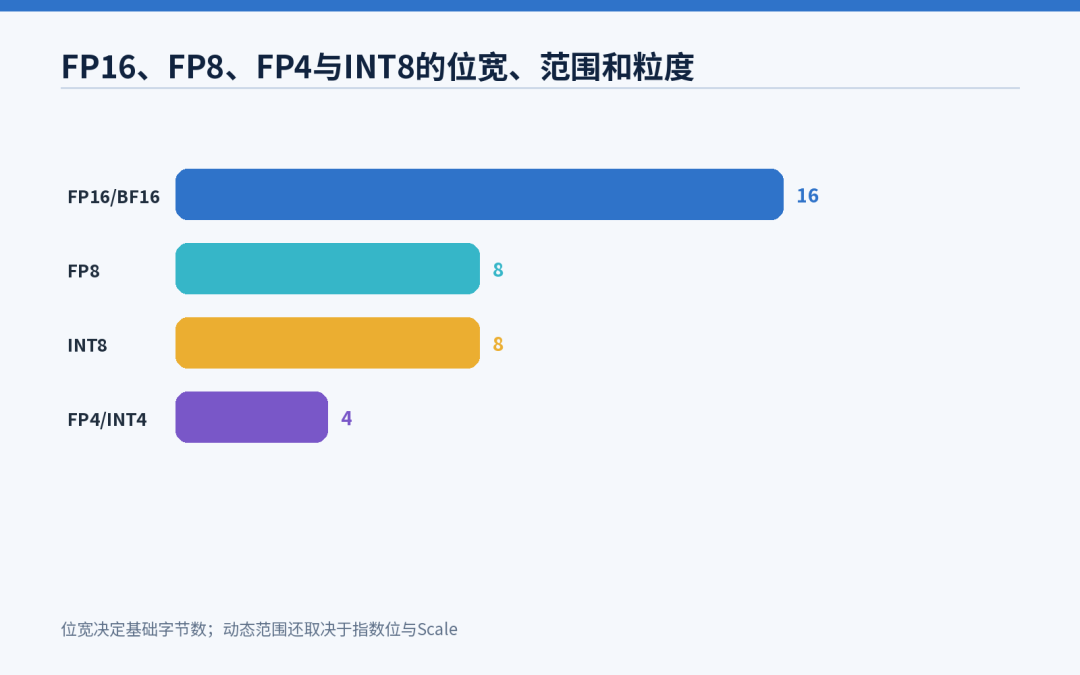
图1 FP16、FP8、FP4与INT8的位宽、范围和粒度
二、量化不是简单截断,而是“映射—计算—还原”
以对称整数量化为例,可把浮点值x映射为整数q:
q=clip(round(x/s), q_(min), q_(max))
其中s是缩放因子。需要近似恢复时使用x̂=s· q。s越大,可覆盖范围越宽,但相邻量化格间距也越大;s太小,离群值会被裁剪。量化误差来自舍入、裁剪和不同尺度共享同一格点。
Per-tensor只用一个Scale,元数据少、Kernel简单,却容易被少数离群值绑架;per-channel或per-group用更多Scale,能更贴近分布,但增加元数据、索引和实现复杂度。动态per-token量化会在运行时统计激活尺度,适应性更强,也多了一段计算。
浮点低精度同样需要缩放。FP8、FP4的指数范围有限,工程实现常用张量级、行级或块级Scale,使数值落入可表达区间。所谓“量化格式”其实包含数据格式、Scale粒度、校准方法和计算Kernel四部分。
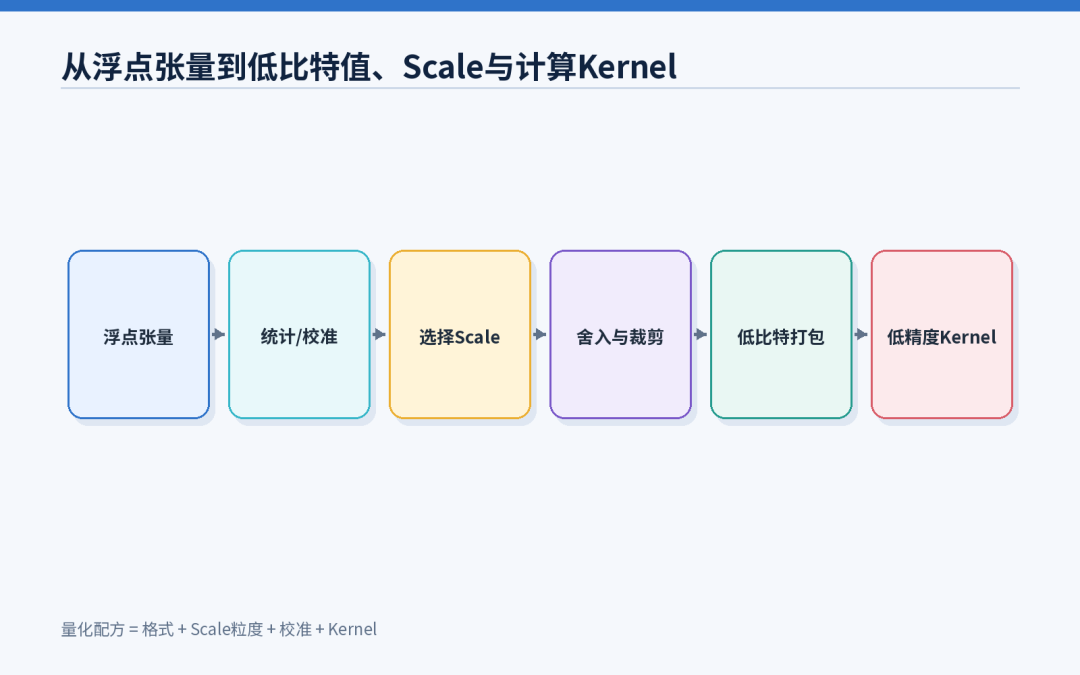
图2 从浮点张量到低比特值、Scale与计算Kernel
三、W8A8、W4A16、FP8 KV Cache分别在优化什么
W8A8表示权重和激活都以8位形式参与主要矩阵计算,目标是同时减少内存流量并利用低精度计算吞吐。W4A16常指权重4位、激活16位:权重存储与读取更省,但计算前可能按块解码或反量化,适合权重带宽占主导的Decode。W4A8又进一步压低激活,却对Kernel与数值稳定性要求更高。
KV Cache量化是另一条路径。它不改变模型权重,而是把每个请求不断增长的K、V缓存压成INT8、FP8或更低精度。收益主要出现在长上下文、高并发:单请求KV更小,显存能容纳更多请求,读取历史KV的带宽也降低。代价是注意力内核必须理解量化布局,并控制长期累积的误差。
所以部署时不能只说“模型用了FP8”。至少要问:权重是什么精度?激活是什么精度?累加用什么精度?KV Cache是什么精度?Embedding、Norm、Softmax、Logits是否保留更高精度?
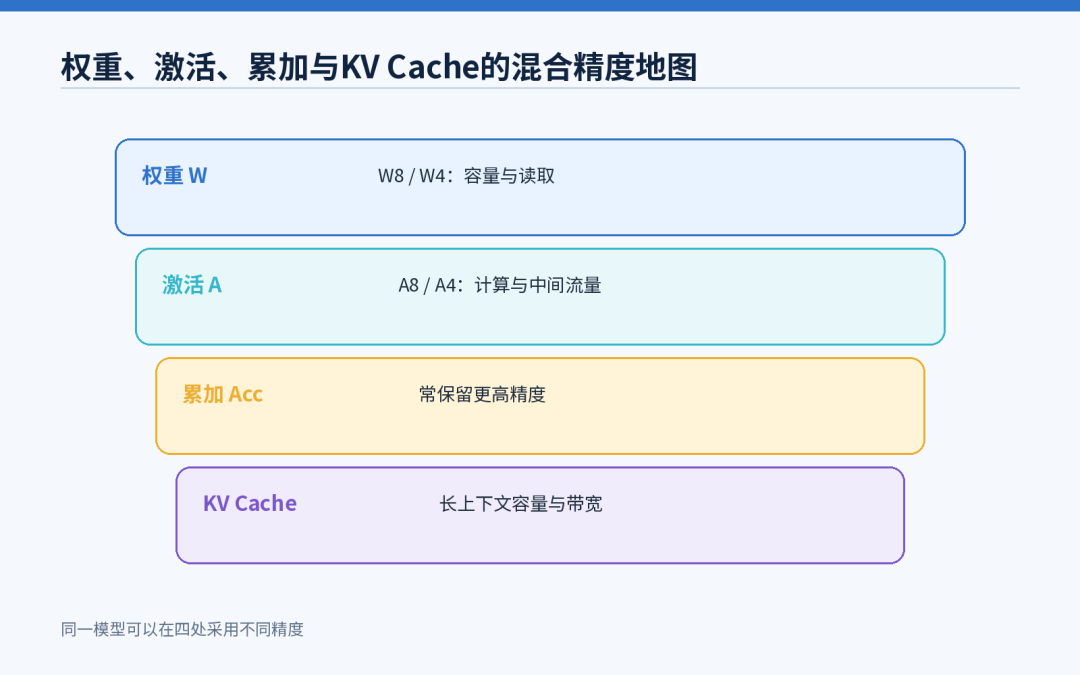
图3 权重、激活、累加与KV Cache的混合精度地图
| 配方 | 主要压缩对象 | 最直接收益 | 典型风险 |
|---|---|---|---|
| W8A8 / FP8 | 权重+激活 | 带宽与低精度计算 | 激活离群值、Scale开销 |
| W4A16 | 权重 | 模型容量、Decode权重带宽 | 反量化、Kernel与精度 |
| W4A8 / FP4路径 | 权重+激活 | 更高压缩与潜在吞吐 | 格式/硬件依赖更强 |
| INT8/FP8 KV | KV Cache | 长上下文容量与读带宽 | 注意力误差、内核支持 |
表1 FP16、FP8、FP4和INT8究竟改变了什么?关键对照
四、为什么激活通常比权重更难量化
权重在部署前固定,可以离线统计、逐层校准并选择Scale。激活随输入变化,某些通道会出现显著离群值;一个Scale若同时覆盖离群值和大量小值,小值的有效分辨率会变差。SmoothQuant的核心思路,是通过数学等价的缩放,把一部分激活量化难度迁移到更容易处理的权重上,从而实现W8A8。
AWQ则关注权重量化时哪些通道对输出更重要。它借助激活统计识别显著权重通道,并通过缩放降低其量化误差,而不是简单认为每个权重同等重要。GPTQ类方法会利用二阶信息或逐层重构思想,尽量补偿量化误差。
这些方法的共同点是:压缩比不是唯一目标,误差如何穿过后续层才是关键。同样平均误差,若集中在敏感通道、注意力投影或输出层,最终质量影响可能完全不同。
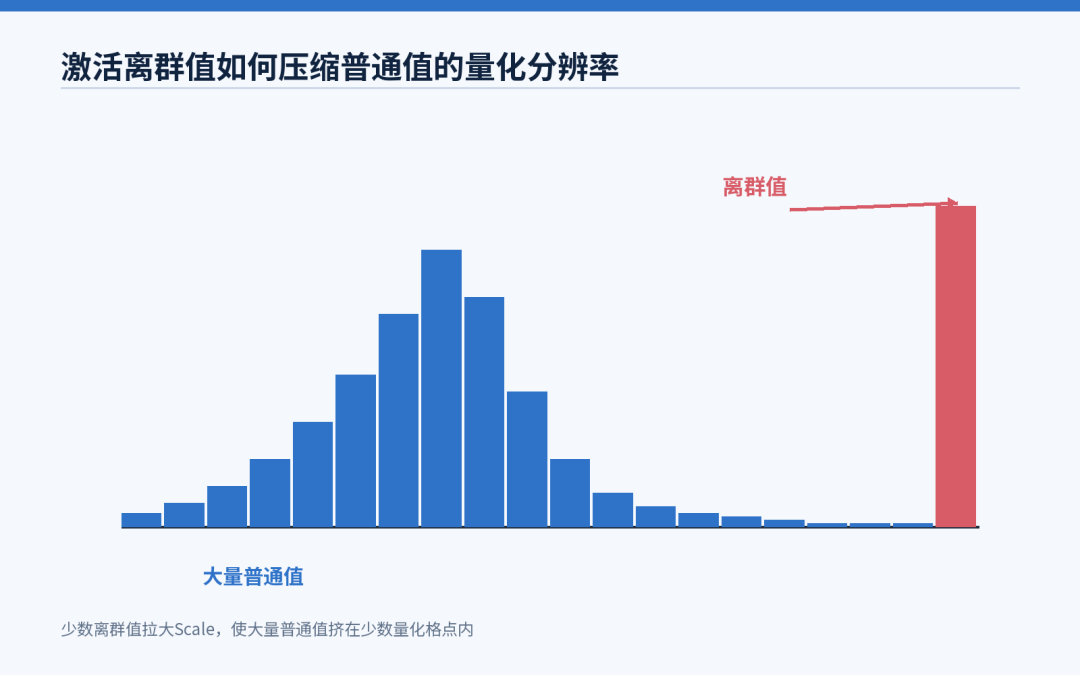
图4 激活离群值如何压缩普通值的量化分辨率
五、低比特何时能换来速度,何时只能换来容量
如果GPU有匹配的数据格式、Tensor Core指令和成熟Kernel,低比特矩阵乘法可以同时减少IO并提高计算吞吐。若硬件只把低比特当压缩存储,运行时仍需反量化成FP16计算,收益主要来自权重读取和容量,反量化还会占用指令与带宽。
矩阵形状也很重要。一个Kernel在大Prefill GEMM上高效,不代表在小批Decode上同样高效;分组Scale和权重打包可能要求特定对齐。若推理框架遇到不支持的层而回退到高精度,频繁类型转换会吃掉收益。
因此,量化评估至少要分三层:模型能否保持任务质量;引擎能否全链路使用目标精度;具体负载下Token/s、TTFT、TPOT和显存是否改善。只比较checkpoint文件大小,不足以回答生产价值。
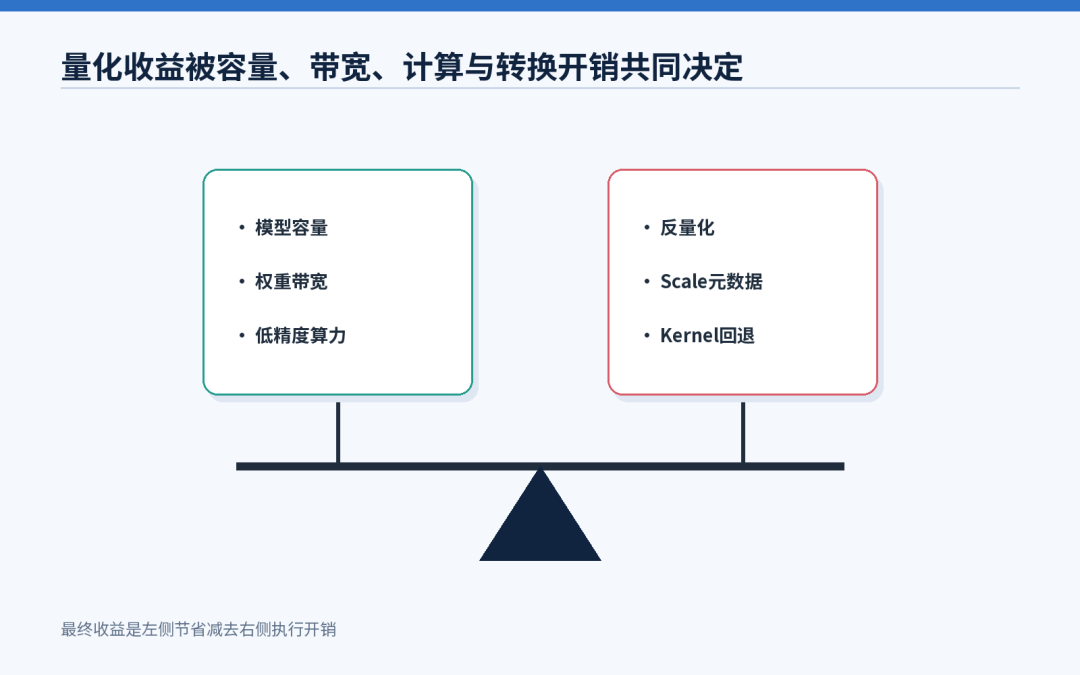
图5 量化收益被容量、带宽、计算与转换开销共同决定
六、为什么“4bit比8bit快一倍”通常不成立
从8位到4位,理论字节数再次减半,但端到端时间还包含不随权重字节线性下降的部分:KV Cache读取、Attention、通信、采样、调度、内核启动和排队。Amdahl定律告诉我们,只加速其中一段,整体加速上限由未加速部分决定。
低比特还可能需要更细粒度Scale、格式转换或校准,4位Tensor Core吞吐也取决于GPU代际。对某些场景,4位的主要价值是让一个原本需要两台服务器的模型装进一台;即使单请求延迟只改善有限,副本密度与每百万Token成本仍可能显著下降。
这说明容量收益、吞吐收益和延迟收益要分别汇报。三者都能降低商业成本,但机制不同。
七、质量评估不能只看一个通用Benchmark
量化误差常表现为困惑度小幅变化,但实际产品更关心代码、数学、长上下文、工具调用、结构化输出和特定语言。低比特模型在平均榜单上差异很小,可能在少数高敏感任务上出现退化。校准数据若与生产分布偏离,也会让离线结果过于乐观。
建议建立三层验证:第一层做数值与困惑度筛查;第二层跑通用能力与关键任务集;第三层做线上影子流量,观察质量、拒答、格式正确率和尾延迟。对于随机采样,应使用足够样本并固定评测协议,避免把随机波动归咎于量化。
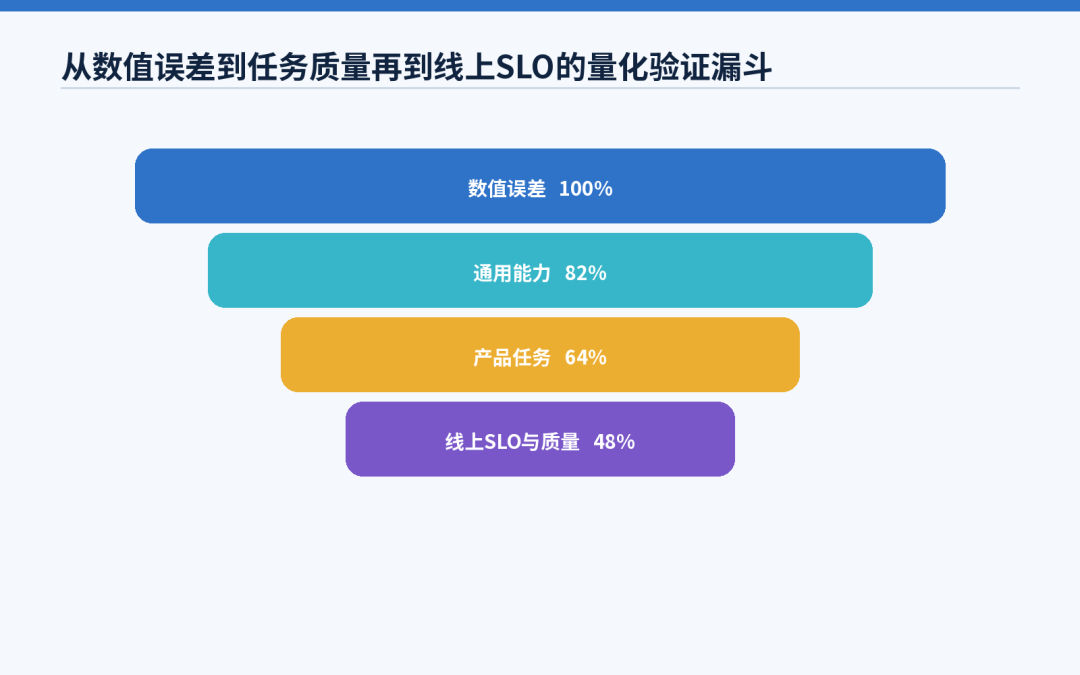
图6 从数值误差到任务质量再到线上SLO的量化验证漏斗
| 必须同时记录的变量 | 为什么重要 |
|---|---|
| 模型版本与量化配方 | 同为FP8/INT4也可能布局不同 |
| 校准数据与样本量 | 决定Scale与敏感通道估计 |
| GPU、Kernel、引擎版本 | 决定是否有真实低精度路径 |
| ISL/OSL、并发与Batch | 决定计算/带宽瓶颈 |
| 质量集与SLO | 防止只优化Token/s而破坏产品 |
表2 FP16、FP8、FP4和INT8究竟改变了什么?关键对照
八、量化的正确目标,是降低“可用Token”的综合成本
最便宜的原始Token若导致质量下降、重试增加或SLO违约,未必是最便宜的可用Token。生产决策应把模型质量、硬件数量、吞吐、功耗、运维复杂度和回退比例放进同一张表。
一条实用路径是:先用Roofline与Profiler确定是否主要受权重/激活/KV带宽限制;再选择与硬件原生支持匹配的精度;然后从保守的8位或FP8起步,逐层验证更低精度;最后用真实流量衡量Goodput和单位合格请求成本。
回到标题:FP16、FP8、FP4和INT8改变的不只是“数字精细程度”,而是每步需要搬运与存放的字节、可调用的计算单元、Scale元数据和误差传播路径。量化之所以能降低Token成本,是因为它可能同时提高模型密度、内存带宽效率和低精度算力利用;能否兑现,则取决于完整软硬件链路。
九、一条可落地的量化部署路径
先建立未量化基线:固定checkpoint、Tokenizer、采样、硬件和负载,记录质量、显存、TTFT、TPOT与Goodput。第二步做敏感性扫描,分别尝试权重、激活和KV Cache量化,避免一次把三个变量同时改变。第三步查看引擎构建日志和Profiler,确认目标层真正使用低精度Kernel,Norm、Softmax与Logits等保留在设计的精度。
第四步按产品任务验收质量,而不是只跑困惑度。代码应检查编译与单测通过率,Agent应检查工具参数,结构化输出应检查Schema,长上下文应检查检索位置与事实一致性。第五步用真实ISL/OSL和并发做在线压测,观察显存节省是否转化为更大Batch或更多副本,以及P99有没有因转换Kernel产生新抖动。
第六步保留可回退配置与版本化量化元数据。Scale、校准集、Kernel版本和模型权重必须绑定,否则“同一个INT4模型”难以复现。第七步再尝试更低位宽或混合精度:把敏感层保留更高精度,把带宽占主导且容错的层降得更低。混合精度不是妥协,而是按误差收益分配比特预算。
最后比较的不应是“4位赢了8位”,而是每种方案在相同质量门槛和SLO下的每GPU Goodput、每百万可售Token成本与运维复杂度。只有这样,量化才从压缩实验变成生产能力。
一个简单自检是把任何量化方案补全成一句话:“某些层的权重采用什么格式、什么Scale粒度,激活与累加是什么精度,KV Cache是否量化,在什么硬件Kernel上运行,并通过哪些质量集验收。”若这句话缺少一半信息,“FP8模型”或“4bit模型”仍不足以预测速度与质量。
量化不是模型文件上的标签,而是一份从数值到硬件的执行合同。
参考资料
·Xiao et al., SmoothQuant:https://arxiv.org/abs/2211.10438
·Lin et al., AWQ:https://arxiv.org/abs/2306.00978
·Frantar et al., GPTQ:https://arxiv.org/abs/2210.17323
·NVIDIA, TensorRT-LLM Quantization:https://nvidia.github.io/TensorRT-LLM/latest/features/quantization.html
本文转载自微信公众号「AI拆解师」,仅供学习交流使用。
觉得内容不错?我要